
8.1: Вступ до оцінки набору
- Page ID
- 99158
Основна теорія
Основна статистична модель
Як завжди, нашою відправною точкою є випадковий експеримент з базовим простором вибірки та мірою ймовірності\(\P\). У базовій статистичній моделі ми маємо спостережувану випадкову величину,\(\bs{X}\) яка приймає значення в множині\(S\). В цілому,\(\bs{X}\) може мати досить складну будову. Наприклад, якщо експеримент полягає в тому, щоб вибірка\(n\) об'єктів з населення і запис різних вимірювань, що цікавлять, то\[ \bs{X} = (X_1, X_2, \ldots, X_n) \] де\(X_i\) знаходиться вектор вимірювань для\(i\) го об'єкта. Найголовніший особливий випадок виникає\((X_1, X_2, \ldots, X_n)\), коли вони незалежні і однаково розподілені. У цьому випадку ми маємо випадкову вибірку розміру\(n\) із загального розподілу.
Припустимо також, що розподіл\(\bs{X}\) залежить від параметра, який\(\theta\) приймає значення в просторі параметрів\(\Theta\). Параметр також може бути векторно-значним, в такому випадку\(\Theta \subseteq \R^k\) для деяких\(k \in \N_+\) і параметр вектор має вигляд\(\bs{\theta} = (\theta_1, \theta_2, \ldots, \theta_k)\).
Набори довіри
Довірчий набір - це\(C(\bs{X})\) підмножина простору параметрів\(\Theta\), яка залежить тільки від змінної даних\(\bs{X}\), і ніяких невідомих параметрів. рівень довіри є найменшою ймовірністю, що\(\theta \in C(\bs{X})\):\[ \min\left\{\P[\theta \in C(\bs{X})]: \theta \in \Theta\right\} \]
Таким чином, в певному сенсі набір довіри - це багатозначна статистика. Набір довіри - це оцінка\(\theta\) в тому сенсі, що ми сподіваємось, що\(\theta \in C(\bs{X})\) з великою ймовірністю, щоб рівень довіри був високим. Відзначимо, що оскільки розподіл\( \bs{X} \) залежить від\( \theta \), існує\( \theta \) залежність від міри ймовірності\( \P \) при визначенні рівня довіри. Однак ми зазвичай пригнічуємо це, просто щоб зберегти позначення простим. Зазвичай ми намагаємося побудувати впевненість, встановлену для\(\theta\) з встановленим рівнем довіри\(1 - \alpha\), де\(0 \lt \alpha \lt 1\). Типові рівні довіри - 0,9, 0,95 та 0,99. Іноді найкраще, що ми можемо зробити, - це побудувати набір довіри, рівень довіри якого принаймні\(1 - \alpha\); це називається консервативною\(1 - \alpha\) впевненістю, встановленою для\(\theta\).
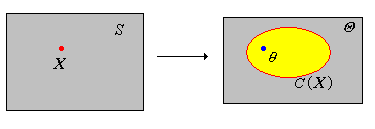
Припустимо,\(C(\bs{X})\) що встановлено\(1 - \alpha\) рівень довіри для параметра\(\theta\). Зверніть увагу, що коли ми запускаємо експеримент і спостерігаємо за даними\(\bs{x}\), обчислюється набір довіри\(C(\bs{x})\). Справжнє значення\(\theta\) знаходиться або в цьому наборі, або ні, і ми зазвичай ніколи не дізнаємося. Однак за законом великих чисел, якби ми повторювали експеримент впевненості знову і знову, частка множин, які містять, сходиться\(\theta\) б до\(\P[\theta \in C(\bs{X})] = 1 - \alpha\). У цьому і полягає точне значення терміна впевненість. У звичайній термінології статистики випадковим набором\(C(\bs{X})\) є оцінювач;\(C(\bs{x})\) детермінований набір, заснований на спостережуваному значенні,\(\bs{x}\) є оцінкою.
Далі зверніть увагу, що якість набору довіри, як оцінювач\(\theta\), базується на двох факторах: рівні довіри та точності, виміряної розміром
набору. Хороший оцінювач має невеликий розмір (а значить, дає точну оцінку\(\theta\)) і велику впевненість. Однак для даного\(\bs{X}\) зазвичай існує компроміс між рівнем довіри та точністю — підвищення рівня довіри відбувається лише за рахунок збільшення розміру набору, а зменшення розміру набору відбувається лише за рахунок зменшення рівня довіри. Як ми вимірюємо розмір
довірчого набору, залежить від розмірності простору параметрів та характеру набору довіри. Причому розмір набору зазвичай випадковий, хоча в деяких особливих випадках він може бути детермінованим.
Враховуючи крайні випадки, ми можемо дати нам деяке розуміння. По-перше, припустимо, що\(C(\bs{X}) = \Theta\). Цей набір оцінювач має максимальну впевненість 1, але немає точності і, отже, він нічого не вартий (ми це вже знали\(\theta \in \Theta\)). З іншого боку, припустимо, що\(C(\bs{X})\) це одноелементний набір. Цей оцінювач набору має найкращу можливу точність, але, як правило, для безперервних розподілів, має впевненість 0. Між цими крайнощами, сподіваюся, встановлюються оцінювачі, які мають високу впевненість і високу точність.
Припустимо, що\(C_i(\bs{X})\) це\(1 - \alpha_i\) рівень довіри, встановлений\(\theta\) для\(i \in \{1, 2, \ldots, k\}\). Якщо\(\alpha = \alpha_1 + \alpha_2 + \cdots + \alpha_k \lt 1\) тоді\(C_1(\bs{X}) \cap C_2(\bs{X}) \cap \cdots \cap C_k(\bs{X})\) консервативний\(1 - \alpha \) рівень довіри встановлений для\(\theta\).
Доказ
Це випливає з нерівності Бонферроні.
Реальні параметри
У багатьох випадках ми зацікавлені в оцінці дійсного параметра,\(\lambda = \lambda(\theta)\) що приймає значення в інтервальному просторі параметрів\((a, b)\), де\(a, \, b \in \R\) з\(a \lt b\). Звичайно, можливо, що\(a = -\infty\) або\(b = \infty\). У цьому контексті наш набір довіри часто має форму,\[ C(\bs{X}) = \left\{\theta \in \Theta: L(\bs{X}) \lt \lambda(\theta) \lt U(\bs{X})\right\} \] де\(L(\bs{X})\) і\(U(\bs{X})\) є реальною статистикою. У цьому випадку\((L(\bs{X}), U(\bs{X}))\) називається довірчим інтервалом для\(\lambda\). Якщо\(L(\bs{X})\) і\(U(\bs{X})\) обидва випадкові, то довірчий інтервал часто кажуть, що двосторонній. В особливому випадку\(U(\bs{X}) = b\), що,\(L(\bs{X})\) називається впевненість нижньої межі для\(\lambda\). В особливому випадку\(L(\bs{X}) = a\), що,\(U(\bs{X})\) називається довіра верхньої межі для\(\lambda\).
Припустимо, що\(L(\bs{X})\) це нижня межа\(1 - \alpha\) рівня довіри для\(\lambda\) і\(U(\bs{X})\) це\(1 - \beta\) рівень довіри верхньої межі для\(\lambda\). Якщо\(\alpha + \beta \lt 1\) тоді\((L(\bs{X}), U(\bs{X}))\) консервативний\(1 - (\alpha + \beta)\) рівень довіри інтервал для\(\lambda\).
Доказ
Це випливає відразу з (2).
Змінні зведення
Ви можете подумати, що побудувати довірчі набори для параметра має бути дуже важко\(\theta\). Однак у багатьох важливих особливих випадках набори довіри можуть бути легко побудовані з певних випадкових величин, відомих як поворотні змінні.
Припустимо, що\(V\) це функція\(S \times \Theta\) from в множина\(T\). Випадкова величина\(V(\bs{X}, \theta)\) є поворотною величиною,\(\theta\) якщо її розподіл не залежить від\(\theta\). Зокрема,\(\P[V(\bs{X}, \theta) \in B]\) є постійним\(\theta \in \Theta\) для кожного\(B \subseteq T\).
Основна ідея полягає в тому, що ми намагаємося об'єднати\(\bs{X}\) і\(\theta\) алгебраїчно таким чином, щоб ми враховували залежність від\(\theta\) в розподілі отриманої випадкової величини\(V(\bs{X}, \theta)\). Якщо ми знаємо розподіл змінної pivot, то для заданої\(\alpha\), ми можемо спробувати знайти\(B \subseteq T\) (що не залежить від\(\theta\)) таке, що\( \P_\theta\left[V(\bs{X}, \theta) \in B\right] = 1 - \alpha \). Потім випливає, що\(1 - \alpha\) довірчий набір для параметра задається\( C(\bs{X}) = \{ \theta \in \Theta: V(\bs{X}, \theta) \in B \} \).
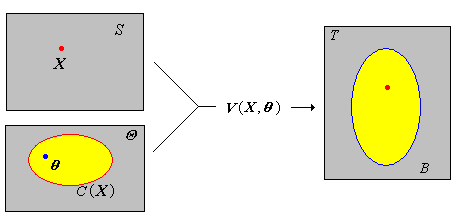
Припустимо тепер, що наша змінна pivot\(V(\bs{X}, \theta)\) є реальною, яка для простоти, ми будемо вважати, що має безперервний розподіл. Для\(p \in (0, 1)\), нехай\(v(p)\) позначимо квантиль порядку\(p\) для змінної зведеної\(V(\bs{X}, \theta)\). За самим значенням змінної pivot,\(v(p)\) не залежить від\(\theta\).
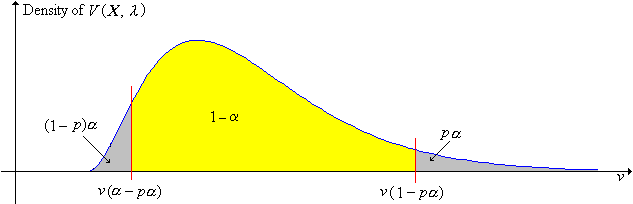
Для будь-якого\(p \in (0, 1)\),\(1 - \alpha\) рівень довіри\(\theta\) встановлений для\[ \left\{\theta \in \Theta: v(\alpha - p \alpha) \lt V(\bs{X}, \theta) \lt v(1 - p \alpha)\right\} \]
Доказ
За визначенням ймовірність події є\((1 - p \alpha) - (\alpha - p \alpha) = 1 - \alpha\).
Довіра, встановлена вище, відповідає\((1 - p) \alpha\) в лівому\(p \alpha\) хвості і в правому хвості, з точки зору розподілу змінної стрижня\(V(\bs{X}, \lambda)\). Особливий випадок\(p = \frac{1}{2}\) - це рівнохвостий випадок, найпоширеніший випадок.
Довіра множина (5) зменшується\(\alpha\) і, отже, збільшується в\(1 - \alpha\) (у сенсі відношення підмножини) для фіксованого\(p\).
Для впевненості набору (5) ми, природно, хотіли б вибрати\(p\), який мінімізує розмір набору в певному сенсі. Однак це часто складна проблема. Рівнохвостий інтервал, відповідний\(p = \frac{1}{2}\), є найбільш часто використовуваним випадком, і іноді (але не завжди) є оптимальним вибором. Змінні Pivot далеко не унікальні; завдання полягає в тому, щоб знайти змінну, розподіл якої відомий і яка дає жорсткі межі параметра (висока точність).
Припустимо, що\(V(\bs{X}, \theta)\) це змінна pivot для\(\theta\). Якщо функція\(g\) визначена на діапазоні\(V\) і не\(g\) включає в себе невідомих параметрів, то також\(U = g[V(\bs{X}, \theta)]\) є змінною зведенням для\(\theta\).
Приклади та особливі випадки
Сім'ї масштабу розташування
У випадку з сімействами розподілів масштабу розташування ми можемо легко знайти змінні зведеного типу. Припустимо, що\(Z\) це дійсна випадкова величина з безперервним розподілом, яка має функцію щільності ймовірності\(g\), і ніяких невідомих параметрів. Нехай\(X = \mu + \sigma Z\) де\(\mu \in \R\) і\(\sigma \in (0, \infty)\) є параметри. Нагадаємо, що функція щільності ймовірності\(X\) задається\[ f_{\mu, \sigma}(x) = \frac{1}{\sigma} g\left( \frac{x - \mu}{\sigma} \right), \quad x \in \R\] і відповідним сімейством розподілів називається сімейством розташування-масштабу, пов'язаним з розподілом\(Z\);\(\mu\) є параметром розташування і\(\sigma\) є параметр масштабу. Як правило, ми припускаємо, що ці параметри невідомі.
Тепер припустимо, що\(\bs{X} = (X_1, X_2, \ldots, X_n)\) це випадкова вибірка розміру\(n\) з розподілу\(X\); це наш спостережуваний вектор результату. Для кожного\(i\) нехай\[ Z_i = \frac{X_i - \mu}{\sigma} \]
Випадковий вектор\(\bs{Z} = (Z_1, Z_2, \ldots, Z_n)\) являє собою випадкову вибірку розміру\(n\) з розподілу\(Z\).
Зокрема, зверніть увагу, що\(\bs{Z}\) це змінна pivot for\((\mu, \sigma)\), так як\(\bs{Z}\) є функцією\(\bs{X}\)\(\mu\)\(\sigma\), і, але розподіл\(\bs{Z}\) не залежить від\(\mu\) або\(\sigma\). Отже, будь-яка функція\(\bs{Z}\) буде також змінною pivot for\((\mu, \sigma)\), (якщо функція не включає параметри). Звичайно, деякі з цих стрижневих змінних будуть набагато кориснішими, ніж інші при оцінці\(\mu\) та\(\sigma\). У наступних вправах ми вивчимо дві загальні та важливі змінні стрижня.
Нехай\(M(\bs{X})\) і\(M(\bs{Z})\) позначають зразки засобів\(\bs{X}\) і\(\bs{Z}\), відповідно. Тоді\(M(\bs{Z})\) є змінною стрижневої для\((\mu, \sigma)\) так\[ M(\bs{Z}) = \frac{M(\bs{X}) - \mu}{\sigma} \]
\(m\)Дозвольте позначити квантильну функцію змінної стрижня\(M(\bs{Z})\). Для будь-якого\(p \in (0, 1)\),\(1 - \alpha\) впевненість,\((\mu, \sigma)\) встановлена для\[ Z_{\alpha, p}(\bs{X}) = \{(\mu, \sigma): M(\bs{X}) - m(1 - p \alpha) \sigma \lt \mu \lt M(\bs{X}) - m(\alpha - p \alpha) \sigma \} \]
Довірчий набір, побудований вище, являє собою конус
у просторі\((\mu, \sigma)\) параметрів, з вершиною на\( (M(\bs{X}), 0) \) і граничними лініями нахилів\(-1 / m(1 - p \alpha)\) і\(-1 / m(\alpha - p \alpha)\), як показано на графіку нижче. (Однак зверніть увагу, що обидва нахили можуть бути негативними або обидва позитивними.)
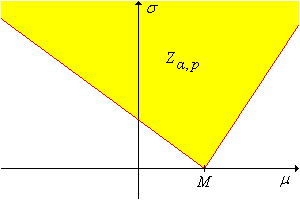
Той факт, що набір довіри необмежений, явно не є хорошим, але, мабуть, не дивно; ми оцінюємо два реальні параметри з єдиною реальною змінною стрижня. Однак, якщо\(\sigma\) відомо, набір довіри визначає довірчий інтервал для\(\mu\). Геометрично довірчий інтервал просто відповідає горизонтальному перерізу в\(\sigma\).
\(1 - \alpha\)набори довіри для\((\mu, \sigma)\) є
- \(Z_{\alpha, 1}(\bs{X}) = \{(\mu, \sigma): M(\bs{X}) - m(1 - \alpha) \sigma \lt \mu \lt \infty\}\)
- \(Z_{\alpha, 0}(\bs{X}) = \{(\mu, \sigma): - \infty \lt \mu \lt M(\bs{X}) - m(\alpha) \sigma\}\)
Доказ
В упевненості встановлюють побудовані вище, нехай\(p \uparrow 1\) і\(p \downarrow 0\), відповідно.
Якщо\(\sigma\) відомо, то (а) дає\(1 - \alpha\) впевненість нижньої межі для\(\mu\) і (b) дає\(1 - \alpha\) впевненість верхню межу для\(\mu\).
Нехай\(S(\bs{X})\) і\(S(\bs{Z})\) позначимо зразком стандартні відхилення\(\bs{X}\) і\(\bs{Z}\), відповідно. Потім\(S(\bs{Z})\) є змінна зведена для\((\mu, \sigma)\) і змінна зведена для\(\sigma\) так\[ S(\bs{Z}) = \frac{S(\bs{X})}{\sigma} \]
Дозвольте\(s\) позначити квантильну функцію\(S(\bs{Z})\). Для будь-якого\(\alpha \in (0, 1)\) і\(p \in (0, 1)\),\(1 - \alpha\) впевненість,\((\mu, \sigma)\) встановлена для\[ V_{\alpha, p}(\bs{X}) = \left\{(\mu, \sigma): \frac{S(\bs{X})}{s(1 - p \alpha)} \lt \sigma \lt \frac{S(\bs{X})}{s(\alpha - p \alpha)} \right\} \]
Зверніть увагу, що набір довіри не дає жодної інформації,\(\mu\) оскільки випадкова величина вище є змінною зведеної для\(\sigma\) поодинці. Набір довіри також можна розглядати як обмежений довірчий інтервал для\(\sigma\).
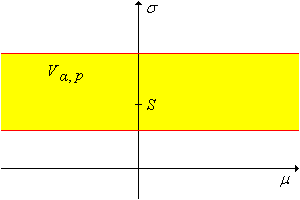
\(1 - \alpha\)набори довіри для\((\mu, \sigma)\) є
- \(V_{\alpha, 1}(\bs{X}) = \left \{ (\mu, \sigma): S(\bs{X}) / s(1 - \alpha) \lt \sigma \lt \infty \right \}\)
- \(V_{\alpha, 0}(\bs{X}) = \left \{ (\mu, \sigma): 0 \lt \sigma \lt S(\bs{X}) / s(\alpha) \right \}\)
Доказ
В упевненості встановлюють побудовані вище, нехай\(p \uparrow 1\) і\(p \downarrow 0\), відповідно.
Набір у частині (а) дає\(1 - \alpha\) впевненість нижню межу для,\(\sigma\) а набір у частині (b) дає\(1 - \alpha\) впевненість верхню межу для\(\sigma\).
Ми можемо перетинати набори довіри, що відповідають двом змінним, щоб створити консервативні, обмежені набори довіри.
Якщо\(\alpha, \; \beta, \; p, \; q \in (0, 1)\) з\(\alpha + \beta \lt 1\)\(Z_{\alpha, p} \cap V_{\beta, q}\) то консервативна\(1 - (\alpha + \beta)\) впевненість встановлена для\((\mu, \sigma)\).
Доказ
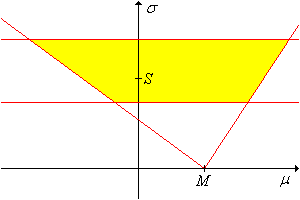
Найважливішою сім'єю масштабу розташування є сімейство нормальних розподілів. У наступному розділі розглядається проблема оцінки в нормальній моделі. В іншій частині цього розділу ми розглянемо ще одну важливу сімейство масштабів.
Експоненціальний розподіл
Нагадаємо, що експоненціальний розподіл з параметром масштабу\(\sigma \in (0, \infty)\) має функцію щільності ймовірності\(f(x) = \frac{1}{\sigma} e^{-x / \sigma}, \; x \in [0, \infty)\). Це сімейство масштабів, пов'язане зі стандартним експоненціальним розподілом, яке має функцію щільності ймовірності\(g(x) = e^{-x}, \; x \in [0, \infty)\). Експоненціальний розподіл широко використовується для моделювання випадкових часів (таких як тривалість життя та час прибуття
), особливо в контексті моделі Пуассона. Тепер припустимо,\(\bs{X} = (X_1, X_2, \ldots, X_n)\) що випадкова вибірка розміру\(n\) з експоненціального розподілу з невідомим параметром масштабу\(\sigma\). Нехай\[ Y = \sum_{i=1}^n X_i \]
Випадкова величина\(\frac{2}{\sigma} Y\) має розподіл хі-квадрат зі\(2 n\) ступенями свободи, а отже, є поворотною змінною для\(\sigma\).
Зауважте, що ця змінна зведена кратна змінній,\( M \) побудованій вище, для загальних сімейств масштабів розташування (з\(\mu = 0\)). Для\(p \in (0, 1)\) і\(k \in (0, \infty)\), давайте\(\chi_k^2(p)\) позначимо квантиль порядку\(p\) для хі-квадратного розподілу зі\(k\) ступенями свободи. Для вибраних значень\(k\) і\(p\),\(\chi_k^2(p)\) можна отримати зі спеціального калькулятора розподілу або з більшості статистичних програмних пакетів.
Нагадаємо, що
- \(\chi_k^2(p) \to 0\)як\(p \downarrow 0\)
- \(\chi_k^2(p) \to \infty\)як\(p \uparrow 1\)
Для будь-якого\(\alpha \in (0, 1)\) і будь-якого\(p \in (0, 1)\)\(1 - \alpha\) довірчий інтервал\(\sigma\) для\[ \left( \frac{2\,Y}{\chi_{2n}^2(1 - p \alpha)}, \frac{2\,Y}{\chi_{2n}^2(\alpha - p \alpha)} \right) \]
Зверніть увагу, що
- \(2 Y \big/ \chi_{2n}^2(1 - \alpha)\)є\(1 - \alpha\) впевненістю нижня межа для\(\sigma\).
- \(2 Y \big/ \chi_{2n}^2(\alpha)\)є\(1 - \alpha\) впевненістю нижня межа для\(\sigma\).
З двосторонніх довірчих інтервалів, побудованих вище, ми, природно, вважаємо за краще той, який має найменшу довжину, оскільки цей інтервал дає найбільше інформації про параметр\(\sigma\). Однак мінімізувати довжину як функцію обчислювально-важко.\(p\) Двосторонній довірчий інтервал, який зазвичай використовується, є рівним хвостатим інтервалом, отриманим шляхом дозволу\(p = \frac{1}{2}\):\[ \left( \frac{2\,Y}{\chi_{2n}^2(1 - \alpha/2)}, \frac{2\,Y}{\chi_{2n}^2(\alpha/2)} \right) \]
Час життя певного типу компонента (у годині) має експоненціальний розподіл з невідомим параметром масштабу\(\sigma\). Десять пристроїв працюють до виходу з ладу; тривалість життя 592, 861, 1470, 2412, 335, 3485, 736, 758, 530, 1961.
- Побудувати 95% двосторонній довірчий інтервал для\(\sigma\).
- Побудувати 95% довіри нижньої межі для\(\sigma\).
- Побудувати 95% довіри верхньої межі для\(\sigma\).
Відповідь
- \((769.1, 2740.1)\)
- 836.7
- 2421.9