
2.3: Вимірювання ймовірності
- Page ID
- 99320
Цей розділ містить остаточний і найважливіший інгредієнт базової моделі випадкового експерименту. Якщо ви новий студент ймовірності, пропустіть технічні деталі.
Визначення та тлумачення
Припустимо, що у нас є випадковий експеримент з вибірковим простором\( (S, \mathscr S) \), так що\( S \) це сукупність результатів експерименту і\( \mathscr S \) є сукупністю подій. Коли ми запускаємо експеримент, задана подія\( A \) або відбувається, або не відбувається, залежно від того, чи є результат експерименту\( A \) чи ні. Інтуїтивно, ймовірність події є мірою того, наскільки імовірно, що подія відбудеться, коли ми проводимо експеримент. Математично ймовірність - це функція на сукупність подій, яка задовольняє певним аксіомам.
Визначення
Міра ймовірності (або розподіл ймовірностей)\(\P\) на\( (S, \mathscr S) \) вибірковому просторі - це дійсна функція, визначена на колекції подій\( \mathscr S \), яка задовольняє наступні аксіоми:
- \(\P(A) \ge 0\)на кожну подію\(A\).
- \(\P(S) = 1\).
- Якщо\(\{A_i: i \in I\}\) є обчислювальною, попарно неспільною сукупністю подій, то\[\P\left(\bigcup_{i \in I} A_i\right) = \sum_{i \in I}\P(A_i)\]
Подробиці
Нагадаємо, що колекція подій\( \mathscr S \) зобов'язана бути\( \sigma \) -алгеброю, яка гарантує, що об'єднання подій в (с) само по собі є подією. Міра ймовірності - це окремий випадок позитивної міри.
Аксіома (c) відома як лічильна адитивність, і стверджує, що ймовірність об'єднання скінченної або незліченно нескінченної колекції непоєднуваних подій є сумою відповідних ймовірностей. Аксіоми відомі як аксіоми Колмогорова, на честь Андрія Колмогорова, який першим формалізував теорію ймовірностей аксіоматичним способом. Більш неофіційно ми говоримо, що\( \P \) це міра ймовірності (або розподіл) на\( S \), колекція подій\( \mathscr S \) зазвичай розуміється.
Аксіоми (a) і (b) насправді просто питання умовності; ми вирішили виміряти ймовірність події з числом між 0 і 1 (на відміну, скажімо, до числа між\(-5\) і\(7\)). Аксіома (c), однак, є фундаментальною і неминучою. Це потрібно для ймовірності точно з тієї ж причини, що вона потрібна для інших мір розміру
множини, таких як кардинальність для скінченних множин, довжина для підмножин\(\R\), площа для підмножин\(\R^2\), і обсяг для підмножин\(\R^3\). У всіх цих випадках розмір набору, який складається з незліченної кількості нероз'єднаних штук, є сумою розмірів штук.
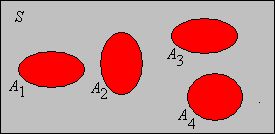
З іншого боку, незліченна адитивність (розширення аксіоми (c) до незліченного набору індексів\(I\)) є необґрунтованою для ймовірності, як і для інших заходів. Наприклад, інтервал позитивної довжини in\(\R\) - це об'єднання незліченної кількості точок, кожна з яких має довжину 0.
Тепер ми визначили три основні інгредієнти для моделі випадкового експерименту:
Простір ймовірностей\( (S, \mathscr S, \P) \) складається з
- Набір результатів\(S\)
- Колекція подій\(\mathscr{S}\)
- Вимірювання ймовірності\(\P\) на просторі вибірки\( (S, \mathscr S) \)
Подробиці
Знову ж таки, колекція подій\( \mathscr S \) - це\( \sigma \) -алгебра, так що простір вибірки\( (S, \mathscr S) \) є вимірним простором. Простір ймовірностей\( (S, \mathscr S, \P) \) є окремим випадком позитивної міри простору.
Закон великих чисел
Інтуїтивно, ймовірність події повинна вимірювати довгострокову відносну частоту події - насправді це поняття було прийнято як визначення ймовірності Річардом Фон Мізесом. Ось відповідні визначення:
Припустимо, що експеримент повторюється нескінченно довго, і\( A \) це подія. Для\( n \in \N_+ \),
- Нехай\( N_n(A) \) позначимо кількість разів, що\( A \) відбувалося. Це частота\( A \) в перших\( n \) пробігах.
- Нехай\( P_n(A) = N_n(A) / n \). Це відносна частота або емпірична ймовірність\( A \) в перших\( n \) тиражах.
Зверніть увагу, що повторення оригінального експерименту нескінченно створює новий, складний експеримент, і що\( N_n(A) \) і\( P_n(A) \) є випадковими величинами для нового експерименту. Зокрема, значення цих змінних є невизначеними до тих пір, поки експеримент не буде запущений\( n \) раз. Основна ідея полягає в тому, що якщо ми вибрали правильну міру ймовірності для експерименту, то в якомусь сенсі ми очікуємо, що відносна частота події повинна сходитися з ймовірністю події. Тобто\[P_n(A) \to \P(A) \text{ as } n \to \infty, \quad A \in \mathscr S\] незалежно від невизначеності відносних частот зліва. Точне твердження цього - закон великих чисел або закон середніх, одна з фундаментальних теорем ймовірності. Щоб підкреслити цю точку, зауважте, що загалом буде багато можливих мір ймовірності для експерименту, у сенсі аксіом. Однак лише міра ймовірності, яка правильно моделює експеримент, задовольнить закон великих чисел.
Враховуючи дані з\( n \) прогонів експерименту, емпірична функція ймовірності\(P_n\) є мірою ймовірності на\( S \).
Доказ
Якщо ми запускаємо\( n \) час експерименту, ми генеруємо\( n \) бали\( S \) (хоча, звичайно, деякі з цих точок можуть бути однаковими). Функція\( A \mapsto N_n(A) \) для\( A \subseteq S \) - це просто підрахунок міри, що відповідає\( n \) точкам. Ясно\( P_n(A) \ge 0 \) для події\( A \) і\( P_n(S) = n / n = 1 \). Підрахувальна адитивність дотримується правила додавання для підрахунку міри.
Розподіл випадкової величини
Припустимо, що тепер\(X\) це випадкова величина для експерименту, приймаючи значення в множині\(T\). Нагадаємо, що математично,\( X \) є функцією from\( S \) into\( T \), і\( \{X \in B\}\) позначає подію\(\{s \in S: X(s) \in B\} \) для\( B \subseteq T \). Інтуїтивно,\( X \) це змінна, що представляє інтерес для експерименту, і кожне змістовне твердження про\( X \) визначає подію.
Функція\(B \mapsto \P(X \in B)\) for\( B \subseteq T \) визначає міру ймовірності на\(T\).
Доказ

Міра ймовірності в (5) називається розподілом ймовірностей\(X\), тому ми маємо всі інгредієнти для нового простору ймовірностей.
Випадкова величина\(X\) зі значеннями в\( T \) визначає новий простір ймовірностей:
- \(T\)це сукупність результатів.
- \( T \)Підмножинами є події.
- Розподіл ймовірності\(X\) є мірою ймовірності на\( T \).
Цей простір ймовірностей відповідає новому випадковому експерименту, в якому є результат\( X \). Більш того, нагадаємо, що сам результат експерименту можна розглядати як випадкову величину. Зокрема, якщо ми\(T = S\) дозволимо нам дозволити\(X\) бути функція ідентичності на\(S\), так що\( X(s) = s \) для\( s \in S \). Потім\(X\) є випадковою величиною зі значеннями в\( S \) і\(\P(X \in A) = \P(A)\) для кожної події\( A \). Таким чином, кожна міра ймовірності може розглядатися як розподіл випадкової величини.
Конструкції
Заходи
Як ми можемо побудувати ймовірнісні міри? Як зазначалося коротко вище, існують інші заходи розміру
множин; у багатьох випадках вони можуть бути перетворені в міри ймовірності. Спочатку позитивна міра\(\mu\) на просторі вибірки\((S, \mathscr S)\) - це реальна функція\(\mathscr{S}\), визначена на якій задовольняє аксіоми (a) і (c) в (1), а потім\( (S, \mathscr S, \mu) \) є вимірним простором. Загалом,\(\mu(A)\) дозволено бути нескінченним. Однак, якщо\(\mu(S)\) є позитивним і кінцевим (так що\( \mu \) це кінцева позитивна міра), то\(\mu\) можна легко масштабувати в міру ймовірності.
Якщо\(\mu\) позитивна міра на\(S\) з,\(0 \lt \mu(S) \lt \infty\) то\(\P\) визначена нижче є мірою ймовірності. \[\P(A) = \frac{\mu(A)}{\mu(S)}, \quad A \in \mathscr S\]
Доказ
- \(\P(A) \ge 0\)так як\(\mu(A) \ge 0\) і\(0 \lt \mu(S) \lt \infty\).
- \(\P(S) = \mu(S) \big/ \mu(S) = 1\)
- Якщо\(\{A_i: i \in I\}\) є зліченою сукупністю неспільних подій, то\[ \P\left(\bigcup_{i \in I} A_i \right) = \frac{1}{\mu(S)} \mu\left(\bigcup_{i \in I} A_i \right) = \frac{1}{\mu(S)} \sum_{i \in I} \mu(A_i) = \sum_{i \in I} \frac{\mu(A_i)}{\mu(S)} = \sum_{i \in I} \P(A_i) \]
У цьому контексті\(\mu(S)\) називається нормалізує константа. У наступних двох підрозділах ми розглянемо деякі дуже важливі особливі випадки.
Дискретні розподіли
У цій дискусії ми припускаємо, що простір вибірки\((S, \mathscr S)\) дискретний. Нагадаємо, що це означає, що набір результатів\(S\)\(\mathscr S = \mathscr P(S)\) підраховується, і це колекція всіх підмножин\(S\), так що кожна підмножина є подією. Стандартна міра на дискретному просторі - це міра підрахунку\(\#\), так що\(\#(A)\) це кількість елементів у\(A\) for\(A \subseteq S\). Коли\( S \) скінченна, міра ймовірності, що відповідає мірі підрахунку, побудованої вище, особливо важлива в комбінаторних і вибіркових експериментах.
Припустимо, що\(S\) це кінцева, непорожня множина. Дискретний рівномірний розподіл на\(S\) задається\[\P(A) = \frac{\#(A)}{\#(S)}, \quad A \subseteq S\]
Базова модель розглядається як класична модель ймовірності, оскільки історично найперші проблеми ймовірності (за участю монет і кубиків) відповідають цій моделі.
У загальному дискретному випадку, якщо\(\P\) є мірою ймовірності на\(S\), то оскільки\( S \) є підрахунковою, випливає з лічильної адитивності, яка повністю\(\P\) визначається її значеннями на одноелетних подіях. Конкретно, якщо ми визначаємо\(f(x) = \P\left(\{x\}\right)\) для\(x \in S\), то\(\P(A) = \sum_{x \in A} f(x)\) для кожного\(A \subseteq S\). За аксіомою (а),\(f(x) \ge 0\) за\(x \in S\) і аксіомою (b),\(\sum_{x \in S} f(x) = 1\). І навпаки, можна дати загальну конструкцію для визначення міри ймовірності на дискретному просторі.
Припустимо, що\( g: S \to [0, \infty) \). Тоді\(\mu\) визначається\( \mu(A) = \sum_{x \in A} g(x) \) for\( A \subseteq S \) є позитивною мірою на\(S\). Якщо\(0 \lt \mu(S) \lt \infty\) потім\(\P\) визначено наступним чином, це показник ймовірності на\(S\). \[ \P(A) = \frac{\mu(A)}{\mu(S)} = \frac{\sum_{x \in A} g(x)}{\sum_{x \in S} g(x)}, \quad A \subseteq S\]
Доказ
Тривіально\(\mu(A) \ge 0\) для\( A \subseteq S \) since\(g\) є ненегативним. Зліченна властивість адитивності має місце, оскільки терміни в сумі невід'ємних чисел можуть бути переставлені будь-яким чином, не змінюючи суму. Таким чином, нехай\(\{A_i: i \in I\}\) буде підрахункова колекція нез'єднаних підмножин\( S \), і нехай\(A = \bigcup_{i \in I} A_i\) тоді\[ \mu(A) = \sum_{x \in A} g(x) = \sum_{i \in I} \sum_{x \in A_i} g(x) = \sum_{i \in I} \mu(A_i) \] якщо\( 0 \lt \mu(S) \lt \infty \) тоді\( \P \) є мірою ймовірності шляхом масштабування результату вище.
У контексті наших попередніх зауважень,\(f(x) = g(x) \big/ \mu(S) = g(x) \big/ \sum_{y \in S} g(y)\) для\( x \in S \). Розподіли цього типу, як кажуть, дискретні. Дискретні розподіли детально вивчені в розділі про розподіли.
Якщо\(S\) скінченна і\(g\) є постійною функцією, то міра ймовірності,\(\P\)\( g \) пов'язана з дискретним рівномірним розподілом на\(S\).
Доказ
Припустимо, що\(g(x) = c\) за\(x \in S\) куди\(c \gt 0\). Тоді\(\mu(A) = c \#(A) \) і, отже\(\P(A) = \mu(A) \big/ \mu(S) = \#(A) \big/ \#(S)\), для\( A \subseteq S \).
Безперервні дистрибутиви
Розподіли ймовірностей, які ми будемо будувати далі, є неперервними розподілами на\( \R^n \) for\( n \in \N_+ \) і вимагають деякого числення.
Для\(n \in \N_+\), стандартна міра\( \lambda_n \) на\( \R^n \) задається\[\lambda_n(A) = \int_A 1 \, dx, \quad A \subseteq \R^n\] Зокрема,\( \lambda_1(A) \) це довжина (A\ subseteq\ R\),\( lambda_2(A) \) є площею\( A \subseteq \R^2 \), і\( \lambda_3(A) \) є об'ємом\( A \subseteq \R^3 \).
Подробиці
Технічно,\( \lambda_n \) є міра Лебега на вимірних підмножин\( \R^n \), названих на честь Анрі Лебега. Представлення вище з точки зору звичайного інтеграла Рімана числення справедливе для підмножин, які зазвичай зустрічаються в додатках. Як завжди, всі\( \R^n \) підмножини в обговоренні нижче вважаються вимірюваними.
Коли\(n \gt 3\), іноді\(\lambda_n(A)\) називають \(n\)-мірним об'ємом\(A \subseteq \R_n\). Особливо важлива міра ймовірності, пов'язана з\( \lambda_n \) множиною з позитивним,\( n \) скінченно-вимірним об'ємом.
Припустимо, що\(S \subseteq \R_n\) з\(0 \lt \lambda_n(S) \lt \infty\). Безперервний рівномірний розподіл на\( S \) визначається\[\P(A) = \frac{\lambda_n(A)}{\lambda_n(S)}, \quad A \subseteq S\]
Зверніть увагу, що безперервний рівномірний розподіл аналогічний дискретному рівномірному розподілу, визначеному в (8), але з мірою Лебега\( \lambda_n \) заміною міри підрахунку\( \# \). Ми можемо узагальнити цю конструкцію для створення багатьох інших дистрибутивів.
Припустимо ще раз те\( S \subseteq \R^n\) і те\( g: S \to [0, \infty) \). Тоді\( \mu \) визначається\( \mu(A) = \int_A g(x) \, dx \) for\( A \subseteq S \) є позитивною мірою на\( S \). Якщо\(0 \lt \mu(S) \lt \infty\), то\( \P \) визначається наступним чином є мірою ймовірності на\( S \). \[\P(A) = \frac{\mu(A)}{\mu(S)} = \frac{\int_A g(x) \, dx}{\int_S g(x) \, dx}, \quad A \in \mathscr S\]
Доказ
Технічно інтегралом у визначенні\(\mu(A)\) є інтеграл Лебега, але цей інтеграл узгоджується зі звичайним інтегралом Рімана числення, коли\(g\) і досить\(A\) приємні. Функція\(g\) вважається вимірною і є функцією щільності щодо\(\lambda_n\).\(\mu\) Технічні аспекти осторонь, доказ простий:
- \( \mu(A) \ge 0 \)бо\( A \subseteq S \) оскільки\( g \) є невід'ємним.
- Якщо\(\{A_i: i \in I\}\) є зліченою неспільною сукупністю підмножин\(S\) і\(A = \bigcup_{i \in I} A_i\), то за базовою властивістю інтеграла,\[\mu(A) = \int_A g(x) \, dx = \sum_{i \in I} \int_{A_i} g(x) \, dx = \sum_{i \in I} \mu(A_i)\]
Якщо\( 0 \lt \mu(S) \lt \infty \) тоді\( \P \) є мірою ймовірності\( S \) за результатом масштабування вище.
Розподіли цього типу, як кажуть, є безперервними. Безперервні дистрибутиви детально вивчені в розділі про розподіли. Зауважте, що неперервний розподіл вище аналогічний дискретному розподілу в (9), але з інтегралами, що замінюють суми. Загальна теорія інтеграції дозволяє уніфікувати ці два особливих випадки, і багато інших крім того.
Правила ймовірності
Основні правила
Знову припустимо, що у нас є випадковий експеримент\( (S, \mathscr S, \P) \), змодельований простором ймовірностей, таким чином,\(S\) це набір результатів,\( \mathscr S \) колекція подій та\( \P \) міра ймовірності. У наступних теоремах\(A\) і\(B\) знаходяться події. Результати легко випливають з аксіом ймовірності в (1), тому обов'язково спробуйте докази самостійно, перш ніж читати ті, що містяться в тексті.
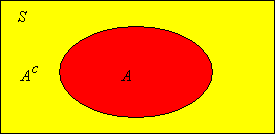
\(\P(A^c) = 1 - \P(A)\). Це відоме як правило доповнення.
Доказ
\(\P(\emptyset) = 0\).
Доказ
Це випливає з правила доповнення, застосованого до\(A = S\).
\(\P(B \setminus A) = \P(B) - \P(A \cap B)\). Це відоме як правило різниці.
Доказ
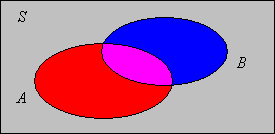
Якщо\(A \subseteq B\) тоді\(\P(B \setminus A) = \P(B) - \P(A)\).
Доказ
Цей результат є наслідком правила різниці. Зверніть увагу, що\(A \cap B = A\).
Нагадаємо, що якщо\( A \subseteq B \) ми іноді пишемо\( B - A \) для встановленої різниці, а не\( B \setminus A \). З цим позначенням правило різниці має приємну форму\( \P(B - A) = \P(B) - \P(A) \).
Якщо\(A \subseteq B\) тоді\(\P(A) \le \P(B)\).
Доказ
Цей результат є наслідком попереднього результату. Зверніть увагу, що\( \P(B \setminus A) \ge 0 \) і значить\( \P(B) - \P(A) \ge 0 \).
Таким чином,\(\P\) є зростаюча функція, щодо підмножини часткового порядку на зборі подій\( \mathscr S \), і звичайний порядок на\(\R\). Зокрема, випливає, що\(\P(A) \le 1\) для будь-якого заходу\(A\).
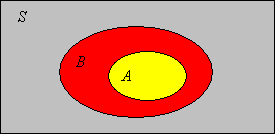
Припустимо, що\(A \subseteq B\).
- Якщо\(\P(B) = 0\) тоді\(\P(A) = 0\).
- Якщо\(\P(A) = 1\) тоді\(\P(B) = 1\).
Доказ
Це випливає відразу з зростаючого властивості в останній теоремі.
Нерівності Буля та Бонферроні
Наступний результат відомий як нерівність Буля, названа на честь Джорджа Була. Нерівність дає просту верхню межу ймовірності об'єднання.
Якщо\(\{A_i: i \in I\}\) є зліченою сукупністю подій, то\[\P\left( \bigcup_{i \in I} A_i \right) \le \sum_{i \in I} \P(A_i)\]
Доказ
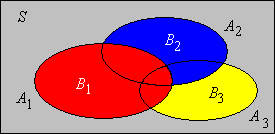
Інтуїтивно нерівність Буля тримається тому, що частини союзу були виміряні не раз в сумі ймовірностей праворуч. Звичайно, сума ймовірностей може бути більшою за 1, і в цьому випадку нерівність Буля не корисна. Наступний результат є простим наслідком нерівності Буля.
Якщо\(\{A_i: i \in I\}\) є зліченою сукупністю подій з\(\P(A_i) = 0\) для кожного\(i \in I\), то\[\P\left( \bigcup_{i \in I} A_i \right) = 0\]
Подія\(A\) з\(\P(A) = 0\) вважається нульовим. Таким чином, зліченний союз нульових подій все ще є нульовою подією.
Наступний результат відомий як нерівність Бонферроні, названа на честь Карло Бонферроні. Нерівність дає просту нижню межу ймовірності перетину.
Якщо\(\{A_i: i \in I\}\) є зліченою сукупністю подій, то\[\P\left( \bigcap_{i \in I} A_i \right) \ge 1 - \sum_{i \in I}\left[1 - \P(A_i)\right]\]
Доказ
За законом Де Моргана,\( \left(\bigcap_{i \in I} A_i\right)^c = \bigcup_{i \in I} A_i^c \). Отже, нерівність Буля,\[ \P\left[\left(\bigcap_{i \in I} A_i\right)^c\right] \le \sum_{i \in I} \P(A_i^c) = \sum_{i \in I} \left[1 - \P(A_i)\right] \] Використання правила доповнення знову дає нерівність Бонферроні.
Звичайно, нижня межа нерівності Бонферроні може бути меншою або дорівнює 0, і в цьому випадку це не корисно. Наступний результат є простим наслідком нерівності Бонферроні.
Якщо\(\{A_i: i \in I\}\) є зліченою сукупністю подій з\(\P(A_i) = 1\) для кожного\(i \in I\), то\[\P\left( \bigcap_{i \in I} A_i \right) = 1\]
Подія\(A\) з іноді\(\P(A) = 1\) називають майже впевненим або майже певним. Таким чином, незліченне перетин майже впевнених подій все ще майже впевнений.
Припустимо, що\(A\) і\(B\) є подіями в експерименті.
- Якщо\(\P(A) = 0\), то\(\P(A \cup B) = \P(B)\).
- Якщо\(\P(A) = 1\), то\(\P(A \cap B) = \P(B)\).
Доказ
- Використовуючи зростаючу властивість і нерівність Буля, ми маємо\( \P(B) \le \P(A \cup B) \le \P(A) + \P(B) = \P(B) \)
- Використовуючи зростаючу властивість і нерівність Бонферонні, ми маємо\( \P(B) = \P(A) + \P(B) - 1 \le \P(A \cap B) \le P(B) \)
Правило розділів
Припустимо, що\(\{A_i: i \in I\}\) це підрахункова колекція подій, які розділяють\(S\). Нагадаємо, що це означає, що події неспільні і їх союз є\(S\). Для будь-якого заходу\(B\),\[\P(B) = \sum_{i \in I} \P(A_i \cap B)\]
Доказ
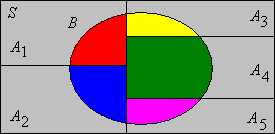
Природно, такий результат корисний, коли відомі ймовірності перетинів. Перегородки зазвичай виникають у зв'язку з випадковою величиною. Припустимо, що\(X\) це випадкова величина, яка приймає значення в обчислювальному множині\(T\), і\(B\) це подія. Тоді\[\P(B) = \sum_{x \in T} \P(X = x, B)\] в цій формулі зверніть увагу, що кома діє подібно символу перетину в попередній формулі.
Правило включення-виключення
Формули включення-виключення дають метод обчислення ймовірності об'єднання подій з точки зору ймовірностей різних перетинів подій. Формула корисна тим, що часто ймовірності перетинів легше обчислити. Цікаво, однак, одна і та ж формула працює для обчислення ймовірності перетину подій з точки зору ймовірностей різних спілок подій. Ця версія рідко заявляється, тому що вона просто не така вже й корисна. Починаємо з двох подій.
Якщо\( A, \, B \) це події, які\(\P(A \cup B) = \P(A) + \P(B) - \P(A \cap B)\).
Доказ

Ось додатковий результат для перетину з точки зору об'єднань:
Якщо події\( A, \, B \), то\(\P(A \cap B) = \P(A) + \P(B) - \P(A \cup B)\).
Доказ
Це випливає відразу з попередньої формули, переставляти терміни.
Далі розглянемо три події.
Якщо події\( A, \, B, \, C \), то\(\P(A \cup B \cup C) = \P(A) + \P(B) + \P(C) - \P(A \cap B) - \P(A \cap C) - \P(B \cap C) + \P(A \cap B \cap C)\).
Аналітичний доказ
Спочатку зауважте, що\( A \cup B \cup C = (A \cup B) \cup [C \setminus (A \cup B)] \). Подія в дужках і подія в квадратних дужках незв'язані. Таким чином, використовуючи аксіому адитивності та правило різниці,\[ \P(A \cup B \cup C) = \P(A \cup B) + \P(C) - \P\left[C \cap (A \cup B)\right] = \P(A \cup B) + \P(C) - \P\left[(C \cap A) \cup (C \cap B)\right] \] Використовуючи правило включення-виключення для двох подій (двічі) ми маємо\[ \P(A \cup B \cup C) = \P(A) + \P(B) - \P(A \cap B) + \P(C) - \left[\P(C \cap A) + \P(C \cap B) - \P(A \cap B \cap C)\right] \]
Підтвердження бухгалтерським обліком
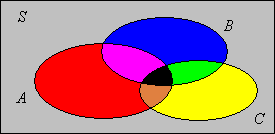
Ось комплементарний результат для ймовірності перетину з точки зору ймовірностей спілок:
Якщо події\( A, \, B, \, C \), то\(\P(A \cap B \cap C) = \P(A) + \P(B) + \P(C) - \P(A \cup B) - \P(A \cup C) - \P(B \cup C) + \P(A \cup B \cup C)\).
Доказ
Це випливає з вирішення for\( \P(A \cap B \cap C) \) в попередньому результаті, а потім використання результату для двох подій на\( \P(A \cap B) \)\( \P(B \cap C) \), і\( \P(A \cap C) \).
Формули включення-виключення для двох і трьох подій можуть бути узагальнені до\(n\) подій. Для решти цього обговорення, припустимо, що\( \{A_i: i \in I\} \) це сукупність подій, де\( I \) є індекс, встановлений з\( \#(I) = n \).
Загальна формула включення-виключення ймовірності союзу. \[\P\left( \bigcup_{i \in I} A_i \right) = \sum_{k = 1}^n (-1)^{k - 1} \sum_{J \subseteq I, \; \#(J) = k} \P\left( \bigcap_{j \in J} A_j \right)\]
Доказ індукцією
Доказ - за допомогою індукції\(n\). Ми вже встановили формулу для\( n = 2 \) і\( n = 3 \). Таким чином, припустимо, що формула включення-виключення тримає для заданого\( n \), і припустимо, що\( (A_1, A_2, \ldots, A_{n+1}) \) це послідовність\( n + 1 \) подій. Тоді\[ \bigcup_{i=1}^{n + 1} A_i = \left(\bigcup_{i=1}^n A_i \right) \cup \left[ A_{n+1} \setminus \left(\bigcup_{i=1}^n A_i\right) \right] \] Як і раніше, подія в дужках і подія в квадратних дужках розмежовуються. Таким чином, використовуючи аксіому адитивності, правило різниці та розподільне правило, яке ми маємо\[ \P\left(\bigcup_{i=1}^{n+1} A_i\right) = \P\left(\bigcup_{i=1}^n A_i\right) + \P(A_{n+1}) - \P\left(\bigcup_{i=1}^n (A_{n+1} \cap A_i) \right) \] За індукційною гіпотезою формула включення-виключення тримає для кожного об'єднання\( n \) подій праворуч. Застосування формули та спрощення дає формулу включення-виключення для\( n + 1 \) подій.
Підтвердження бухгалтерським обліком
Це загальна версія того ж аргументу, який ми використовували вище для 3 подій. \( \bigcup_{i \in I} A_i \)є об'єднанням нез'єднаних подій форми,\( \left(\bigcap_{i \in K} A_i\right) \cap \left(\bigcap_{i \in K^c} A_i\right)\) де\( K \) є непорожня підмножина множини індексу\( I \). У формулі включення-виключення подія, що відповідає заданому,\( K \) вимірюється\( \P\left(\bigcap_{j \in J} A_j\right) \) для кожного непорожнього\( J \subseteq K \). Припустимо, що\( \#(K) = k \). Облік позитивних і негативних ознак, чистий вимір є\( \sum_{j=1}^k (-1)^{j-1} \binom{k}{j} = 1 \).
Ось додатковий результат для ймовірності перетину з точки зору ймовірностей різних спілок:
Загальна формула включення-виключення ймовірності перетину. \[\P\left( \bigcap_{i \in I} A_i \right) = \sum_{k = 1}^n (-1)^{k - 1} \sum_{J \subseteq I, \; \#(J) = k} \P\left( \bigcup_{j \in J} A_j \right)\]
Загальні формули включення-виключення не варто згадувати докладно, а лише за зразком. Для ймовірності союзу починаємо з суми ймовірностей подій, потім віднімаємо ймовірності всіх парних перетинів, потім додаємо ймовірності перетинів третього порядку і так далі, чергуючи знаки, поки не дійдемо до ймовірності перетину всіх події.
Загальні нерівності Бонферроні (для об'єднання) стверджують, що якщо сума справа в загальній формулі включення-виключення обрізана, то усічена сума є верхньою або нижньою межою для ймовірності зліва, залежно від того, чи має останній член позитивний або негативний знак. Ось результат, вказаний явно:
Припустимо, що\( m \in \{1, 2, \ldots, n - 1\} \). Тоді
- \(\P\left( \bigcup_{i \in I} A_i \right) \le \sum_{k = 1}^m (-1)^{k - 1} \sum_{J \subseteq I, \; \#(J) = k} \P\left( \bigcap_{j \in J} A_j \right)\)якщо\( m \) непарно.
- \(\P\left( \bigcup_{i \in I} A_i \right) \ge \sum_{k = 1}^m (-1)^{k - 1} \sum_{J \subseteq I, \; \#(J) = k} \P\left( \bigcap_{j \in J} A_j \right)\)якщо\( m \) подія.
Доказ
Дозвольте\( P_k = \sum_{J \subseteq I, \; \#(J) = k} \P\left( \bigcap_{j \in J} A_j \right) \), абсолютне значення\( k \) го члена у формулі включення-виключення. Результат випливає, оскільки формула включення-виключення є чергуючим рядом і\( P_k \) зменшується в\( k \).
Більш витончені докази формули включення-виключення та нерівностей Бонферроні можуть бути побудовані з використанням очікуваного значення.
Зауважте, що у формулах включення-виключення є термін ймовірності для кожної\( J \) непорожньої підмножини множини індексу\( I \), з позитивним або негативним знаком, і, отже, є\( 2^n - 1 \) такі терміни. Цих ймовірностей вистачає для обчислення ймовірності будь-якої події, яка може бути побудована з заданих подій, а не тільки об'єднання або перетину.
Імовірність будь-якої події, з якої можна побудувати,\( \{A_i: i \in I\} \) можна обчислити з будь-якої з наступних збірок\( 2^n - 1 \) ймовірностей:
- \( \P\left(\bigcap_{j \in J} A_j\right) \)де\( J \) — непорожня підмножина\( I \).
- \( \P\left(\bigcup_{j \in J} A_j\right) \)де\( J \) — непорожня підмножина\( I \).
Зауваження
Якщо ви повернетеся назад і подивитеся на свої докази правил ймовірності вище, ви побачите, що вони дотримуються будь-якої кінцевої міри\(\mu\), а не лише ймовірності. Єдина зміна полягає в тому, що цифра 1 замінюється на\(\mu(S)\). Зокрема, правило включення-виключення так само важливо в комбінаториці (вивченні міри підрахунку), як і в ймовірності.
Приклади і застосування
Правила ймовірності
Припустимо, що\(A\) і\(B\) є подіями в експерименті з\(\P(A) = \frac{1}{3}\),\(\P(B) = \frac{1}{4}\),\(\P(A \cap B) = \frac{1}{10}\). Висловіть кожне з наступних подій мовою експерименту і знайдіть його ймовірність:
- \(A \setminus B\)
- \(A \cup B\)
- \(A^c \cup B^c\)
- \(A^c \cap B^c\)
- \(A \cup B^c\)
Відповідь
- \(A\)відбувається, але ні\(B\). \(\frac{7}{30}\)
- \(A\)або\(B\) відбувається. \(\frac{29}{60}\)
- Одне з подій не відбувається. \(\frac{9}{10}\)
- Жодна подія не відбувається. \(\frac{31}{60}\)
- Або\(A\) відбувається, або\(B\) не відбувається. \(\frac{17}{20}\)
Припустимо\(A\)\(B\), що,, і\(C\) є подіями в експерименті з\(\P(A) = 0.3\)\(\P(B) = 0.2\),\(\P(C) = 0.4\),\(\P(A \cap B) = 0.04\),\(\P(A \cap C) = 0.1\),,\(\P(B \cap C) = 0.1\),\(\P(A \cap B \cap C) = 0.01\). Висловіть кожну з наступних подій в заданих позначеннях і знайдіть його ймовірність:
- Принаймні одна з трьох подій відбувається.
- Жодна з трьох подій не відбувається.
- Відбувається рівно одне з трьох подій.
- Відбуваються рівно дві з трьох подій.
Відповідь
- \(\P(A \cup B \cup C) = 0.67\)
- \(\P[(A \cup B \cup C)^c] = 0.37\)
- \(\P[(A \cap B^c \cap C^c) \cup (A^c \cap B \cap C^c) \cup (A^c \cap B^c \cap C)] = 0.45\)
- \(\P[(A \cap B \cap C^c) \cup (A \cap B^c \cap C) \cup (A^c \cap B \cap C)] = 0.21\)
Припустимо, що\(A\) і\(B\) є подіями в експерименті з\(\P(A \setminus B) = \frac{1}{6}\)\(\P(B \setminus A) = \frac{1}{4}\), і\(\P(A \cap B) = \frac{1}{12}\). Знайдіть ймовірність кожного з наступних подій:
- \(A\)
- \(B\)
- \(A \cup B\)
- \(A^c \cup B^c\)
- \(A^c \cap B^c\)
Відповідь
- \(\frac{1}{4}\)
- \(\frac{1}{3}\)
- \(\frac{1}{2}\)
- \(\frac{11}{12}\)
- \(\frac{1}{2}\)
Припустимо, що\(A\) і\(B\) є подіями в експерименті з\(\P(A) = \frac{2}{5}\)\(\P(A \cup B) = \frac{7}{10}\), і\(\P(A \cap B) = \frac{1}{6}\). Знайдіть ймовірність кожного з наступних подій:
- \(B\)
- \(A \setminus B\)
- \(B \setminus A\)
- \(A^c \cup B^c\)
- \(A^c \cap B^c\)
Відповідь
- \(\frac{7}{15}\)
- \(\frac{7}{30}\)
- \(\frac{3}{10}\)
- \(\frac{5}{6}\)
- \(\frac{3}{10}\)
Припустимо\(A\)\(B\), що, і\(C\) є події в експерименті з\(\P(A) = \frac{1}{3}\),\(\P(B) = \frac{1}{4}\),\(\P(C) = \frac{1}{5}\).
- Використовуйте нерівність Буля, щоб знайти верхню межу для\(\P(A \cup B \cup C)\).
- Використовуйте нерівність Бонферроніса, щоб знайти нижню межу для\(\P(A \cap B \cap C)\).
Відповідь
- \(\frac{47}{60}\)
- \(-\frac{83}{60}\), не корисно.
Відкрийте простий експеримент з ймовірністю.
- Зверніть увагу на 16 подій, які можуть бути побудовані з\( A \) та\( B \) використовуючи набір операцій об'єднання, перетину та доповнення.
- \( \P(B) \)Наведено\( \P(A) \), і\( \P(A \cap B) \) в таблиці використовуйте правила ймовірності, щоб перевірити ймовірності інших подій.
- Проведіть експеримент 1000 разів і порівняйте відносні частоти подій з ймовірностями подій.
Припустимо\(A\)\(B\), що,, і\(C\) є подіями в випадковому експерименті з\( \P(A) = 1/4 \)\( \P(B) = 1/3 \)\( \P(C) = 1/6 \),\( \P(A \cap B) = 1/18 \),\( \P(A \cap C) = 1/16 \),,\( \P(B \cap C) = 1/12 \), і\( \P(A \cap B \cap C) = 1/24 \). Знайдіть ймовірності різних спілок:
- \( A \cup B \)
- \( A \cup C \)
- \( B \cup C \)
- \( A \cup B \cup C \)
Відповідь
- \( 19/36 \)
- \( 17/48 \)
- \( 5/12 \)
- \( 85/144 \)
Припустимо\(A\)\(B\), що,, і\(C \) є подіями в випадковому експерименті з\( \P(A) = 1/4 \)\( \P(B) = 1/4 \)\( \P(C) = 5/16 \),\( \P(A \cup B) = 7/16 \),\( \P(A \cup C) = 23/48 \),,\( \P(B \cup C) = 11/24 \), і\( \P(A \cup B \cup C) = 7/12 \). Знайдіть ймовірності різних перетинів:
- \( A \cap B \)
- \( A \cap C \)
- \( B \cap C \)
- \( A \cap B \cap C \)
Відповідь
- \( 1/16 \)
- \( 1/12 \)
- \( 5/48 \)
- \( 1/48 \)
Припустимо\(A\), що\(B\), і\(C\) є подіями в випадковому експерименті. Явно дати всі нерівності Бонферроні для\( \P(A \cup B \cup C) \)
Доказ
- \( \P(A \cup B \cup C) \le \P(A) + \P(B) + \P(C) \)
- \( \P(A \cup B \cup C) \ge \P(A) + \P(B) + \P(C) - \P(A \cap B) - \P(A \cap C) - \P(B \cap C) \)
- \( \P(A \cup B \cup C) = \P(A) + \P(B) + \P(C) - \P(A \cap B) - \P(A \cap C) - \P(B \cap C) + \P(A \cap B \cap C)\)
Монети
Розглянемо випадковий експеримент підкидання монети\(n\) раз і запису послідовності балів\(\bs{X} = (X_1, X_2, \ldots, X_n)\) (де 1 позначає голови, а 0 позначає хвости). Цей експеримент є загальним прикладом випробувань\(n\) Бернуллі, названих на честь Якова Бернуллі. Зверніть увагу, що набір результатів є\(S = \{0, 1\}^n\) набором бітових рядків довжини\(n\). Якщо монета справедлива, то, імовірно, за самим значенням слова, у нас немає підстав віддати перевагу одному пункту в\(S\) іншому. Таким чином, як модельне припущення, здається розумним дати\(S\) рівномірний розподіл ймовірностей, при якому всі результати однаково вірогідні.
Припустимо, що справедлива монета кидається 3 рази і послідовність балів монет записується. Нехай\(A\) буде подія, що перша монета - це голови і\(B\) подія, що є рівно 2 голови. Задайте кожну з наступних подій у вигляді списку, а потім обчислите ймовірність події:
- \(A\)
- \(B\)
- \(A \cap B\)
- \(A \cup B\)
- \(A^c \cup B^c\)
- \(A^c \cap B^c\)
- \(A \cup B^c\)
Відповідь
- \(\{100, 101, 110, 111\}\),\(\frac{1}{2}\)
- \(\{110, 101, 011\}\),\(\frac{3}{8}\)
- \(\{110, 101\}\),\(\frac{1}{4}\)
- \(\{100, 101, 110, 111, 011\}\),\(\frac{5}{8}\)
- \(\{000, 001, 010, 100, 011, 111\}\),\(\frac{3}{4}\)
- \(\{000, 001, 010\}\),\(\frac{3}{8}\)
- \(\{100, 101, 110, 111, 000, 010, 001\}\),\(\frac{7}{8}\)
В експерименті з монетами виберіть 3 монети. Виконайте експеримент 1000 разів, оновлюючи після кожного пробігу, і обчислюйте емпіричну ймовірність кожної події в попередній вправі.
Припустимо, що справедлива монета кидається 4 рази і записується послідовність балів. Нехай\(Y\) позначимо кількість головок. Дайте подію\(\{Y = k\}\) (як підмножину простору вибірки) у вигляді списку\(k \in \{0, 1, 2, 3, 4\}\), для кожного, а потім вкажіть ймовірність події.
Відповідь
- \(\{Y = 0\} = \{0000\}\),\(\P(Y = 0) = \frac{1}{16}\)
- \(\{Y = 1\} = \{1000, 0100, 0010, 0001\}\),\(\P(Y = 1) = \frac{4}{16}\)
- \(\{Y = 2\} = \{1100, 1010, 1001, 0110, 0101, 0011\}\),\(\P(Y = 2) = \frac{6}{16}\)
- \(\{Y = 3\} = \{1110, 1101, 1011, 0111\}\),\(\P(Y = 3) = \frac{4}{16}\)
- \(\{Y = 4\} = \{1111\}\),\(\P(Y = 4) = \frac{1}{16}\)
Припустимо, що справедлива монета\(n\) кидається раз і послідовність балів записується. Нехай\(Y\) позначимо кількість головок.
\[\P(Y = k) = \binom{n}{k} \left( \frac{1}{2} \right)^n, \quad k \in \{0, 1, \ldots, n\}\]Доказ
Кількість бітових рядків довжини\(n\) є\(2^n\), і оскільки монета справедлива, вони однаково вірогідні. Кількість бітових рядків довжини\(n\) з рівно\(k\) 1 є\(\binom{n}{k}\). Звідси ймовірність 1 відбувається рівно\(k\) раз є\(\binom{n}{k} \big/ 2^n\).
Розподіл\(Y\) в останній вправі - це окремий випадок біноміального розподілу. Біноміальний розподіл більш детально вивчено в розділі про випробування Бернуллі.
Кубики
Розглянемо експеримент з кидання\(n\) чітких,\(k\) -односторонніх кубиків (з гранями, пронумерованими від 1 до\(k\)) і запису послідовності балів\(\bs{X} = (X_1, X_2, \ldots, X_n)\). Ми можемо записати результат як послідовність через припущення, що кістки різні; ви можете думати про кістки як якимось чином позначені від 1 до\(n\), або, можливо, з різними кольорами. Особливий випадок\(k = 6\) відповідає стандартним кубикам. Загалом, зверніть увагу, що набір результатів є\(S = \{1, 2, \ldots, k\}^n\). Якщо кістки справедливі, то знову ж таки, за самим значенням слова, у нас немає підстав віддавати перевагу одній точці\( S \) над іншою, тому в якості моделювання припущення здається розумним дати\(S\) рівномірний розподіл ймовірностей.
Припустимо, що кидаються два чесних, стандартних кубика і записана послідовність балів. Давайте\(A\) позначимо подію, що перший бал вмирає менше 3 і\(B\) подія, що сума балів кістки дорівнює 6. Надайте кожну з наступних подій у формі списку, а потім знайдіть ймовірність події.
- \(A\)
- \(B\)
- \(A \cap B\)
- \(A \cup B\)
- \(B \setminus A\)
Відповідь
- \(\{(1,1),(1,2),(1,3),(1,4),(1,5),(1,6),(2,1),(2,2),(2,3),(2,4),(2,5),(2,6)\}\),\(\frac{12}{36}\)
- \(\{(1,5),(5,1),(2,4),(4,2),(3,3)\}\),\(\frac{5}{36}\)
- \(\{(1,5), (2,4)\}\),\(\frac{2}{36}\)
- \(\{(1,1),(1,2),(1,3),(1,4),(1,5),(1,6),(2,1),(2,2),(2,3),(2,4),(2,5),(2,6),(5,1),(4,2),(3,3)\}\),\(\frac{15}{36}\)
- \(\{(5,1), (4,2), (3,3)\}\),\(\frac{3}{36}\)
У експерименті з кубиками встановлюйте\(n = 2\). Проведіть експеримент 100 разів і обчислите емпіричну ймовірність кожної події в попередній вправі.
Розглянемо ще раз експеримент з кістками з\(n = 2\) чесними кістками. Нехай\( S \) позначають набір результатів,\(Y\) суму балів,\(U\) мінімальний бал і\(V\) максимальний бал.
- \(Y\)Висловити як функцію на\( S \) і дати набір значень.
- Знайти\(\P(Y = y)\) для кожного\(y\) в наборі в частині (а).
- \(U\)Висловити як функцію на\( S \) і дати набір значень.
- Знайти\(\P(U = u)\) для кожного\(u\) в наборі в частині (c).
- \(V\)Висловити як функцію на\( S \) і дати набір значень.
- Знайти\(\P(V = v)\) для кожного\(v\) в наборі в частині (е).
- Знайдіть набір значень\((U, V)\).
- Знайти\(\P(U = u, V = v)\) для кожного\((u, v)\) в наборі в частині (г).
Відповідь
Зверніть увагу, що\( S = \{1, 2, 3, 4, 5, 6\}^2 \).
- \(Y(x_1, x_2) = x_1 + x_2\)для\( (x_1, x_2) \in S \). Сукупність значень\(\{2, 3, \ldots, 12\}\)
-
\(y\) 2 3 4 5 6 7 8 9 10 11 12 \(\P(Y = y)\) \(\frac{1}{36}\) \(\frac{2}{36}\) \(\frac{3}{36}\) \(\frac{4}{36}\) \(\frac{5}{36}\) \(\frac{6}{36}\) \(\frac{5}{36}\) \(\frac{4}{36}\) \(\frac{3}{36}\) \(\frac{2}{36}\) \(\frac{1}{36}\) - \(U(x_1, x_2) = \min\{x_1, x_2\}\)для\( (x_1, x_2) \in S \). Сукупність значень\(\{1, 2, 3, 4, 5, 6\}\)
-
\(u\) 1 2 3 4 5 6 \(\P(U = u)\) \(\frac{11}{36}\) \(\frac{9}{36}\) \(\frac{7}{36}\) \(\frac{5}{36}\) \(\frac{3}{36}\) \(\frac{1}{36}\) - \(V(x_1, x_2) = \max\{x_1, x_2\}\)для\( (x_1, x_2) \in S \). Сукупність значень\(\{1, 2, 3, 4, 5, 6\}\)
-
\(v\) 1 2 3 4 5 6 \(\P(V = v)\) \(\frac{1}{36}\) \(\frac{3}{36}\) \(\frac{5}{36}\) \(\frac{7}{36}\) \(\frac{9}{36}\) \(\frac{11}{36}\) - \(\left\{(u, v) \in S: u \le v\right\}\)
- \(\P(U = u, V = v) = \begin{cases} \frac{2}{36}, & u \lt v \\ \frac{1}{36}, & u = v \end{cases}\)
У попередній вправі зверніть увагу, що\((U, V)\) може служити вектором результату для експерименту прокатки двох стандартних, справедливих кубиків, якщо ми не турбуємося розрізнити кістки (так що ми могли б також записати менший бал спочатку, а потім більший бал). Зверніть увагу, що цей випадковий вектор не має рівномірного розподілу. З іншого боку, ми могли б вибрати на початку просто записати невпорядкований набір балів і, як моделювання припущення, наклали рівномірний розподіл на відповідний набір результатів. Обидві моделі не можуть бути правильними, так яка модель (якщо така є) описує реальні кістки в реальному світі? Виходить, що для реальних (чесних) кубиків упорядкована послідовність балів розподілена рівномірно, тому справжні кістки поводяться як окремі об'єкти, чи можна їх розрізнити чи ні. У ранній історії ймовірності гравці іноді отримували неправильні відповіді на події, пов'язані з гральними кістками, оскільки помилково застосовували рівномірний розподіл до набору невпорядкованих балів. Це важлива мораль. Якщо ми маємо накласти рівномірний розподіл на простір зразка, ми повинні переконатися, що це правильний простір зразка.
Пара чесних, стандартних кісток кидається неодноразово, поки сума балів не складе 5 або 7. \(A\)Позначимо подію, що сума балів за останній кидок дорівнює 5, а не 7. Події такого типу важливі в грі в кісточки.
- Припустимо, що ми записуємо пару балів на кожному кидку. Дайте набір результатів\(S\) і висловіть\(A\) як підмножину\(S\).
- Обчислити ймовірність\(A\) в установці частини (а).
- Тепер припустимо, що ми просто записуємо пару балів на останньому кидку. Дайте набір результатів\(T\) і висловіть\(A\) як підмножину\(T\).
- Обчислити ймовірність\(A\) в установці деталей (в).
Відповідь
Нехай\(D_5 = \{(1,4), (2,3), (3,2), (4,1)\}\),\(D_7 = \{(1,6), (2,5), (3,4), (4,3), (5,2), (6,1)\}\),\(D = D_5 \cup D_7\),\(C = \{1, 2, 3, 4, 5, 6\}^2 \setminus D\)
- \(S = D \cup (C \times D) \cup (C^2 \times D) \cup \cdots\),\(A = D_5 \cup (C \times D_5) \cup (C^2 \times D_5) \cup \cdots\)
- \(\frac{2}{5}\)
- \(T = D\),\(A = D_5\)
- \(\frac{2}{5}\)
Попередня проблема показує важливість правильного визначення набору результатів. Іноді розумний вибір цього набору (і відповідні моделюючі припущення) може перетворити складну задачу в легку.
Моделі відбору проб
Нагадаємо, що багато випадкових експериментів можна розглядати як експерименти з вибіркою. Для загальної моделі скінченної вибірки ми починаємо з популяції\(D\) з\(m\) (відмінними) об'єктами. Відбираємо вибірку\(n\) об'єктів з популяції, щоб\(S\) вибірковий простір був сукупністю можливих зразків. Якщо вибрати вибірку навмання, то результат\(\bs{X}\) (випадкова вибірка) рівномірно розподіляється на\(S\):\[\P(\bs{X} \in A) = \frac{\#(A)}{\#(S)}, \quad A \subseteq S\] Нагадаємо з розділу про комбінаторні структури, що існує чотири загальні типи вибірки з кінцевої популяції, засновані на критеріях порядку і заміна.
- Якщо відбір проб йде з заміною і щодо порядку, то набір зразків - декартова потужність\(D^n\). Кількість зразків -\(m^n\).
- Якщо відбір проб проводиться без заміни і щодо порядку, то набір зразків - це набір всіх перестановок розміру\(n\) з\(D\). Кількість зразків -\(m^{(n)} = m (m - 1) \cdots (m - n + 1)\).
- Якщо вибірка проходить без заміни і без урахування порядку, то набір зразків - це сукупність всіх комбінацій (або підмножин) розміру\(n\) з\(D\). Кількість зразків -\(\binom{m}{n} = m^{(n)} / n!\).
- Якщо відбір проб йде з заміною і без урахування замовлення, то набір зразків - це набір всіх мультимножин розміру\(n\) від\(D\). Кількість зразків -\(\binom{m + n - 1}{n}\).
Якщо ми вибірку з заміною, розмір вибірки\(n\) може бути будь-яким натуральним цілим числом. Якщо ми проводимо вибірку без заміни, розмір вибірки не може перевищувати чисельність населення, тому ми повинні мати\(n \in \{1, 2, \ldots, m\}\).
Основні експерименти з монетами та кістками - приклади вибірки з заміною. Якщо ми кидаємо справедливу монету\(n\) раз і записуємо послідовність балів\(\bs{X}\) (де, як зазвичай, 0 позначає хвости, а 1 позначає голови), то\(\bs{X}\) це випадкова вибірка розміру,\(n\) вибрана з порядком і з заміною від населення\(\{0, 1\}\). Таким чином\(\bs{X}\), рівномірно розподіляється по\(\{0, 1\}^n\). Якщо ми кидаємо\(n\) (відмінні) стандартні чесні кістки і запишемо послідовність балів, то генеруємо випадкову\(\bs{X}\) вибірку розміру\(n\) з порядком і з заміною від населення\(\{1, 2, 3, 4, 5, 6\}\). Таким чином\(\bs{X}\), рівномірно розподіляється по\(\{1, 2, 3, 4, 5, 6\}^n\). Аналогічний результат буде триматися за чесні,\(k\) -односторонні кістки.
Припустимо, що проба проходить без заміни (найпоширеніший випадок). Якщо ми записуємо упорядкований зразок\(\bs{X} = (X_1, X_2, \ldots, X_n)\), то \(\bs{W} = \{X_1, X_2, \ldots\}\)невпорядкований зразок є випадковою величиною (тобто функцією\(\bs{X}\)). З іншого боку, якщо ми просто запишемо невпорядкований зразок\(\bs{W}\) в першу чергу, то ми не можемо відновити замовлений зразок.
Припустимо,\(\bs{X}\) що випадкова вибірка розміру\(n\)\(\bs{X}\) вибирається з порядком і без заміни від\(D\), так що рівномірно розподіляється на просторі перестановок розміру\(n\) від\(D\). Потім\(\bs{W}\), невпорядкований зразок, рівномірно розподіляється на просторі комбінацій розміру\(n\) від\(D\). Таким чином, також\(\bs{W}\) є випадковою вибіркою.
Доказ
\(\bs{w}\)Дозволяти поєднання розміру\(n\) від\(D\). Потім відбуваються\(n!\) перестановки елементів в\(\bs{w}\). Якщо\(A\) позначає цей набір перестановок, то\(\P(\bs{W} = \bs{w}) = \P(\bs{X} \in A) = n! \big/ m^{(n)} = 1 \big/ \binom{m}{n}\).
Результат в останній вправі не тримається, якщо проділ з заміною (згадайте вправу вище і подальше обговорення). При вибірці з заміною не існує простої залежності між кількістю впорядкованих зразків і кількістю невпорядкованих зразків.
Вибірка з дихотомного населення
Припустимо ще раз, що у нас є популяція\(D\) з\(m\) (відмінними) об'єктами, але припустимо, що тепер кожен об'єкт є одним з двох типів - тип 1 або тип 0. Такі популяції, як кажуть, дихотомні. Ось кілька конкретних прикладів:
- Населення складається з осіб, кожен або чоловічий або жіночий.
- Населення складається з виборців, кожен або демократ, або республіканець.
- Населення складається з пристроїв, кожен або хороший, або несправний.
- Населення складається з кульок, кожен або червоного або зеленого кольору.
Припустимо, що\(D\) сукупність має об'єкти\(r\) типу 1 і, отже, об'єкти\(m - r\) типу 0. Звичайно, ми повинні мати\(r \in \{0, 1, \ldots, m\}\). Тепер припустимо, що ми вибираємо вибірку розміру\(n\) навмання з популяції. Зауважимо, що дана модель має три параметри: чисельність населення\(m\), кількість об'єктів типу 1 у популяції\(r\) та розмір вибірки\(n\). Нехай\(Y\) позначимо кількість предметів типу 1 в зразку.
Якщо відбір проб без заміни, то\[\P(Y = y) = \frac{\binom{r}{y} \binom{m - r}{n - y}}{\binom{m}{n}}, \quad y \in \{0, 1, \ldots, n\}\]
Доказ
Нагадаємо, що невпорядкована вибірка рівномірно розподілена по безлічі комбінацій розміру,\(n\) обраних з популяції. Є\(\binom{m}{n}\) такі зразки. За принципом множення кількість зразків з об'єктами\(y\) типу 1 та об'єктами\(n - y\) типу 0 дорівнює\(\binom{r}{y} \binom{m - r}{n - y}\).
У попередній вправі випадкова величина\(Y\) має гіпергеометричний розподіл з параметрами\(m\)\(r\), і\(n\). Гіпергеометричний розподіл більш детально вивчено в розділі про моделі вибірки Findite.
Якщо відбір проб з заміною, то\[\P(Y = y) = \binom{n}{y} \frac{r^y (m - r)^{n-y}}{m^n} = \binom{n}{y} \left( \frac{r}{m}\right)^y \left( 1 - \frac{r}{m} \right)^{n - y}, \quad y \in \{0, 1, \ldots, n\}\]
Доказ
Нагадаємо, що упорядкований зразок рівномірно розподілений по\(D^n\) безлічі і в цьому наборі є\(m^n\) елементи. Для підрахунку кількості зразків з точно об'єктами\(y\) типу 1 ми використовуємо триетапну процедуру: спочатку вибираємо координати для об'єктів типу 1; є\(\binom{n}{y}\) варіанти. Далі виберіть об'єкти\(y\) типу 1 для цих координат; є\(r^y\) варіанти. Нарешті, виберіть об'єкти\(n - y\) типу 0 для решти координат зразка; є\((m - r)^{n - y}\) варіанти. Результат тепер випливає з принципу множення.
В останній вправі випадкова величина\(Y\) має біноміальний розподіл з параметрами\(n\) і\(p = \frac{r}{m}\). Біноміальний розподіл більш детально вивчено в розділі про випробування Бернуллі.
Припустимо, що група виборців складається з 40 демократів і 30 республіканців. Вибірка 10 виборців вибирається випадковим чином. Знайдіть ймовірність того, що вибірка містить не менше 4 демократів і не менше 4 республіканців, кожен з наступних випадків:
- Відбір проб проводиться без заміни.
- Відбір проб проводиться з заміною.
Відповідь
- \(\frac{1\,391\,351\,589}{2\,176\,695\,188} \approx 0.6382\)
- \(\frac{24\,509\,952}{40\,353\,607} \approx 0.6074\)
Шукайте інші спеціалізовані ситуації вибірки у вправах нижче.
Моделі урн
Малювання кульок з урни - стандартна метафора ймовірності для вибірки з кінцевої популяції.
Розглянемо урну з 30 кульками; 10 червоних і 20 зелених. Зразок з 5 кульок вибирається навмання, без заміни. Нехай\(Y\) позначимо кількість червоних кульок в зразку. Явно обчислити\(\P(Y = y)\) для кожного\(y \in \{0, 1, 2, 3, 4, 5\}\).
відповідь
| \(y\) | 0 | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|---|
| \(\P(Y = y)\) | \(\frac{2584}{23751}\) | \(\frac{8075}{23751}\) | \(\frac{8550}{23751}\) | \(\frac{3800}{23751}\) | \(\frac{700}{23751/}\) | \(\frac{42}{23751}\) |
У симуляції експерименту з кулькою та урною виберіть 30 кульок з 10 червоними та 20 зеленими, розмір зразка 5 та відбір проб без заміни. Виконайте експеримент 1000 разів і порівняйте емпіричні ймовірності з істинними ймовірностями, які ви обчислили в попередній вправі.
Розглянемо знову урну з 30 кульками; 10 червоних і 20 зелених. Зразок з 5 кульок вибирається навмання, з заміною. Нехай\(Y\) позначимо кількість червоних кульок в зразку. Явно обчислити\(\P(Y = y)\) для кожного\(y \in \{0, 1, 2, 3, 4, 5\}\).
Відповідь
| \(y\) | 0 | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|---|
| \(\P(Y = y)\) | \(\frac{32}{243}\) | \(\frac{80}{243}\) | \(\frac{80}{243}\) | \(\frac{40}{243}\) | \(\frac{10}{243}\) | \(\frac{1}{243}\) |
У симуляції експерименту з кулькою та урною виберіть 30 кульок з 10 червоними та 20 зеленими, розмір зразка 5 та відбір проб із заміною. Виконайте експеримент 1000 разів і порівняйте емпіричні ймовірності з істинними ймовірностями, які ви обчислили в попередній вправі.
Урна містить 15 кульок: 6 червоних, 5 зелених і 4 синіх. Три кульки вибираються навмання, без заміни.
- Знайдіть ймовірність того, що обрані кульки будуть все одного кольору.
- Знайдіть ймовірність того, що обрані кульки будуть все різного кольору.
Відповідь
- \(\frac{34}{455}\)
- \(\frac{120}{455}\)
Припустимо ще раз, що урна містить 15 куль: 6 червоних, 5 зелених, а 4 синіх. Три кульки вибираються навмання, з заміною.
- Знайдіть ймовірність того, що обрані кульки будуть все одного кольору.
- Знайдіть ймовірність того, що обрані кульки будуть все різного кольору.
Відповідь
- \(\frac{405}{3375}\)
- \(\frac{720}{3375}\)
Картки
Нагадаємо, що стандартна колода карт може бути змодельована набором виробів,\[D = \{1, 2, 3, 4, 5, 6, 7, 8, 9, 10, j, q, k\} \times \{\clubsuit, \diamondsuit, \heartsuit, \spadesuit\}\] де перша координата кодує номінал або вид (туз, 2—10, валет, дама, король) і де друга координата кодує масть (трефи, ромби, серця, піки). Іноді ми представляємо карту як рядок, а не впорядковану пару (наприклад,\(q \heartsuit\) для королеви сердець).
Карткові ігри припускають вибір випадкового зразка без заміни з колоди\(D\), яка грає роль населення. Таким чином, базовий картковий експеримент складається з роздачі\(n\) карт зі стандартної колоди без заміни; в цьому особливому контексті зразок карт часто називають рукою. Так само, як і в загальній моделі вибірки, якщо ми записуємо впорядковану руку\(\bs{X} = (X_1, X_2, \ldots, X_n)\)\(\bs{W} = \{X_1, X_2, \ldots, X_n\}\), то невпорядкована рука є випадковою величиною (тобто функцією\(\bs{X}\)). З іншого боку, якщо ми просто запишемо невпорядковану руку\(\bs{W}\) в першу чергу, то ми не можемо відновити впорядковану руку. Нарешті, нагадаємо, що\(n = 5\) це покерний експеримент і\(n = 13\) є мостовим експериментом. Більш детально гра в покер розглядається в розділі про азартні ігри. До речі, для рандомізації колоди карт потрібно близько 7 стандартних перетасовок.
Припустимо, що з добре перетасованої колоди роздаються 2 карти і записується послідовність карт. Бо\(i \in \{1, 2\}\), давайте\(H_i\) позначимо подію, що карта\(i\) - це серце. Знайдіть ймовірність кожного з наступних подій.
- \(H_1\)
- \(H_1 \cap H_2\)
- \(H_2 \setminus H_1\)
- \(H_2\)
- \(H_1 \setminus H_2\)
- \(H_1 \cup H_2\)
Відповідь
- \(\frac{1}{4}\)
- \(\frac{1}{17}\)
- \(\frac{13}{68}\)
- \(\frac{1}{4}\)
- \(\frac{13}{68}\)
- \(\frac{15}{34}\)
Подумайте про результати в попередній вправі, і припустимо, що ми продовжуємо роздавати карти. Зверніть увагу, що при обчисленні ймовірності\(H_i\), ви могли б концептуально звести експеримент до обробки однієї карти. Відзначимо також, що ймовірності не залежать від того, в якому порядку роздаються карти. Наприклад, ймовірність події за участю 1-ї, 2-ї і 3-ї карт збігається з ймовірністю відповідної події за участю 25-ї, 17-ї і 40-ї карт. Технічно карти обмінні. Ось ще один спосіб думати про цю концепцію: припустимо, що карти роздаються на стіл за певною схемою, але ви не маєте права переглядати процес. Тоді жоден експеримент, який ви можете придумати, не дасть вам ніякої інформації про порядок роздачі карт.
У картковому експерименті встановлюйте\(n = 2\). Проведіть експеримент 100 разів і обчислите емпіричну ймовірність кожної події в попередній вправі
В покерному експерименті знайдіть ймовірність кожної з наступних подій:
- Рука - це фул-хаус (3 карти одного виду і 2 карти іншого виду).
- Рука має чотири види (4 карти одного виду і 1 іншого виду).
- Карти всі в одній масті (таким чином, рука або флеш, або стрит-флеш).
Відповідь
- \(\frac{3744}{2\,598\,960} \approx 0.001441\)
- \(\frac{624}{2\,598\,960} \approx 0.000240\)
- \(\frac{5148}{2\,598\,960} \approx 0.001981\)
Запустіть покерний експеримент 10000 разів, оновлюючи кожні 10 запусків. Обчислити емпіричну ймовірність кожної події в попередній задачі.
Знайдіть ймовірність того, що рука моста не буде містити ніяких карток честі, тобто карт номіналу 10, валета, дами, короля або туза. Така рука називається Ярборо, на честь другого графа Ярборо.
Відповідь
\(\frac{347\,373\,600}{635\,013\,559\,600} \approx 0.000547\)
Знайдіть ймовірність того, що рука моста буде містити
- Рівно 4 серця.
- Рівно 4 серця і 3 піки.
- Рівно 4 серця, 3 піки і 2 трефи.
Відповідь
- \(\frac{151\,519\,319\,380}{635\,013\,559\,600} \approx 0.2386\)
- \(\frac{47\,079\,732\,700}{635\,013\,559\,600} \approx 0.0741\)
- \(\frac{11\,404\,407\,300}{635\,013\,559\,600} \approx 0.0179\)
Карткова рука, яка не містить карт у певній масті, як кажуть, є недійсною в цій масті. Скористайтеся правилом включення-виключення, щоб знайти ймовірність кожної з наступних подій:
- Рука покеру є недійсною принаймні в одній масті.
- Рука моста є недійсною принаймні в одній масті.
Відповідь
- \(\frac{1\,913\,496}{2\,598\,960} \approx 0.7363\)
- \(\frac{32\,427\,298\,180}{635\,013\,559\,600} \approx 0.051\)
Дні народження
Наступна проблема відома як проблема дня народження, і відома тим, що результати спочатку досить дивовижні.
Припустимо, що відібрані\(n\) особи і записані їх дні народження (будемо ігнорувати високосні роки). Давайте\(A\) позначимо подію, що дні народження відрізняються, так що\(A^c\) це подія, що є хоча б одне дублювання в дні народження.
- Визначте відповідний простір вибірки та міру ймовірності. Викладіть припущення, які ви робите.
- Знайти\(P(A)\) і\(\P(A^c)\) в плані параметра\(n\).
- Явно обчислювати\(P(A)\) і\(P(A^c)\) для\(n \in \{10, 20, 30, 40, 50\}\)
Відповідь
- Сукупність результатів - це те,\(S = D^n\) де\(D\) знаходиться сукупність днів року. Ми припускаємо, що результати однаково вірогідні, так що\(S\) має рівномірний розподіл.
- \(\#(A) = 365^{(n)}\), так\(\P(A) = 365^{(n)} / 365^n\) і\(\P(A^c) = 1 - 365^{(n)} / 365^n\)
-
\(n\) \(\P(A)\) \(\P(A^c)\) 10 0.883 0.117 20 0,589 0,411 30 0,294 0.706 40 0.109 0.891 50 0,006 0,994
Невелике значення\(\P(A)\) для відносно невеликих розмірів вибірки\(n\) вражає, але обумовлено математично тим, що\(365^n\) зростає набагато швидше, ніж у\(365^{(n)}\) міру\(n\) збільшення. Проблема дня народження розглядається в більш загальному вигляді в розділі про Моделі скінченної вибірки.
Припустимо, що відібрано 4 людини і записуються місяці їх народження. Припускаючи відповідний рівномірний розподіл, знайдіть ймовірність того, що місяці різні.
Відповідь
\(\frac{11880}{20736} \approx 0.573\)
Безперервні рівномірні розподіли
Нагадаємо, що в експерименті з монетами Буффона монета з радіусом випадковим чином\(r \le \frac{1}{2}\)
кидається на підлогу квадратними плитками довжиною сторони 1, а координати\((X, Y)\) центру монети записуються, щодо осей через центр квадрата, в якому монета приземляється (з осями паралельно сторонам квадрата, звичайно). Нехай\(A\) позначимо подію, щоб монета не торкалася сторін квадрата.
- Визначте набір результатів\(S\) математично і намалюйте\(S\).
- \((X, Y)\)Аргументують, що рівномірно розподіляються по\(S\).
- Експрес з\(A\) точки зору кінцевих змінних\((X, Y)\) і ескізу\(A\).
- Знайти\(\P(A)\).
- Знайти\(\P(A^c)\).
Відповідь
- \(S = \left[-\frac{1}{2}, \frac{1}{2}\right]^2\)
- Оскільки монета кидається
випадковим чином
, жоден регіон не\(S\) повинен бути кращим перед будь-яким іншим. - \(\left\{r - \frac{1}{2} \lt X \lt \frac{1}{2} - r, r - \frac{1}{2} \lt Y \lt \frac{1}{2} - r\right\}\)
- \(\P(A) = (1 - 2 \, r)^2\)
- \(\P(A^c) = 1 - (1 - 2 \, r)^2\)
У експерименті з монетами Буффона, набір\(r = 0.2\). Проведіть експеримент 100 разів і обчислите емпіричну ймовірність кожної події в попередній вправі.
Точка\((X, Y)\) вибирається випадковим чином у круговій області\(S \subset \R^2\) радіуса 1, зосередженої на початку координат. Нехай\(A\) позначимо подію, що точка знаходиться в області вписаного квадрата з центром у початку, зі сторонами, паралельними осям координат, і нехай\(B\) позначимо подію, що точка знаходиться в вписаному квадраті з вершинами\((\pm 1, 0)\),\((0, \pm 1)\). Намалюйте кожну з наступних подій як підмножину\(S\), і знайдіть ймовірність події.
- \(A\)
- \(B\)
- \(A \cap B^c\)
- \(B \cap A^c\)
- \(A \cap B\)
- \(A \cup B\)
Відповідь
- \(2 / \pi\)
- \(2 / \pi\)
- \((6 - 4 \sqrt{2}) \big/ \pi\)
- \((6 - 4 \sqrt{2}) \big/ \pi\)
- \(4(\sqrt{2} - 1) \big/ \pi\)
- \(4(2 - \sqrt{2}) \big/ \pi\)
Припустимо,\((X, Y)\) що точка вибрана випадковим чином у\(S \subseteq \R^2\) круговій області радіуса 12, зосередженої на початку координат. Нехай\(R\) позначають відстань від початку до точки. Намалюйте кожну з наступних подій як\(S\) підмножину та обчислите ймовірність події. \(R\)Рівномірно розподіляється на проміжку\([0, 12]\)?
- \(\{R \le 3\}\)
- \(\{3 \lt R \le 6\}\)
- \(\{6 \lt R \le 9\}\)
- \(\{9 \lt R\le 12\}\)
Відповідь
Ні,\(R\) не рівномірно розподіляється по\([0, 12]\).
- \(\frac{1}{16}\)
- \(\frac{3}{16}\)
- \(\frac{5}{16}\)
- \(\frac{7}{16}\)
У простому експерименті з ймовірностями точки генеруються відповідно до рівномірного розподілу на прямокутник. Перемістіть та змінюйте розмір подій\( A \)\( B \) та зверніть увагу на те, як змінюються ймовірності різних подій. Створіть кожну з наступних конфігурацій. У кожному конкретному випадку запустіть експеримент 1000 разів і порівняйте відносні частоти подій з ймовірностями подій.
- \( A \)і\( B \) в загальному становищі
- \( A \)і\( B \) нероз'єднаний
- \( A \subseteq B \)
- \( B \subseteq A \)
Генетика
Будь ласка, зверніться до обговорення генетики в розділі про випадкові експерименти, якщо вам потрібно переглянути деякі визначення в цьому підрозділі.
Нагадаємо спочатку, що група крові АВО у людини визначається трьома алелями:\(a\),\(b\), і\(o\). Крім того,\(a\) і\(b\) є домінуючими і\(o\) є рецесивними. Припустимо, що розподіл ймовірностей для набору генотипів крові в певній популяції наведено в наступній таблиці:
| Генотип | \(aa\) | \(ab\) | \(ao\) | \(bb\) | \(bo\) | \(oo\) |
|---|---|---|---|---|---|---|
| Імовірність | 0,050 | 0,038 | 0,310 | 0,007 | 0,116 | 0,479 |
Людина вибирається навмання з населення. Нехай\(A\),\(B\),\(AB\), і\(O\) бути події, що людина тип\(A\), тип\(B\), тип\(AB\), і тип\(O\) відповідно. Нехай\(H\) буде подія, що людина гомозиготний і\(D\) подія, що у людини є\(o\) алель. Знайдіть ймовірність наступних подій:
- \(A\)
- \(B\)
- \(AB\)
- \(O\)
- \(H\)
- \(D\)
- \(H \cup D\)
- \(D^c\)
Відповідь
- 0,360
- 0,123
- 0,038
- 0,479
- 0,536
- 0,905
- 0,962
- 0.095
Припустимо, далі, що колір стручка у певного виду рослини гороху визначається геном з двома алелями:\(g\) для зеленого і\(y\) для жовтого, і що\(g\) є домінуючим.
Нехай\(G\) буде подія, що у дитини рослина має зелені стручки. Знайти\(\P(G)\) в кожному з наступних випадків:
- Принаймні один з батьків - тип\(gg\).
- Обидва батьки - тип\(yy\).
- Обидва батьки - тип\(gy\).
- Один з батьків - тип,\(yy\) а інший - тип\(gy\).
Відповідь
- \(1\)
- \(0\)
- \(\frac{3}{4}\)
- \(\frac{1}{2}\)
Далі розглянемо спадковий розлад, пов'язаний із статтю у людей (наприклад, дальтонізм або гемофілія). Нехай\(h\) позначають здоровий алель і\(d\) дефектний алель для гена, пов'язаного з розладом. Нагадаємо, що\(d\) є рецесивним для жінок.
Нехай\(B\) буде подія, що у сина розлад,\(C\) подія, що дочка - здоровий носій, і\(D\) подія, що у дочки є хвороба. Знайти\(\P(B)\),\(\P(C)\) причому\(\P(D)\) в кожному з наступних випадків:
- Мати і батько нормальні.
- Мати - здоровий носій, а батько - нормальний.
- Мати нормальна, а у батька розлад.
- Мати є здоровим носієм, а батько має розлад.
- У матері розлад, а батько нормальний.
- Мати і батько обидва мають розлад.
Відповідь
- \(0\),\(0\),\(0\)
- \(1/2\), 0,\(1/2\)
- \(0\),\(1/2\),\(0\)
- \(1/2\),\(1/2\),\(1/2\)
- \(1\),\(1/2\),\(0\)
- \(1\),\(0\),\(1\)
З цієї вправи зауважте, що передача розладу дочці може відбуватися лише в тому випадку, якщо мати є принаймні носієм, а батько має розлад. У звичайних великих популяціях це незвичайне перетин подій, і тому спадкові розлади, пов'язані з статтю, як правило, набагато рідше зустрічаються у жінок, ніж у чоловіків. Якщо коротко, жінки захищені зайвою Х-хромосомою.
Радіоактивні викиди
Припустимо, що\(T\) позначає час між викидами (у мілісекундах) для певного типу радіоактивного матеріалу, і що\(T\) має наступний розподіл ймовірностей, визначених для вимірюваних\(A \subseteq [0, \infty)\)\[\P(T \in A) = \int_A e^{-t} \, dt\]
- Показати, що це дійсно визначає розподіл ймовірностей.
- Знайти\(\P(T \gt 3)\).
- Знайти\(\P(2 \lt T \lt 4)\).
Відповідь
- Зверніть увагу, що\( \int_0^\infty e^{-t} \, dt = 1 \)
- \(e^{-3}\)
- \(e^{-2} - e^{-4}\)
Припустимо, що\(N\) позначає кількість викидів за один мілісекундний інтервал для певного виду радіоактивного матеріалу, і що\(N\) має наступний розподіл ймовірностей:\[\P(N \in A) = \sum_{n \in A} \frac{e^{-1}}{n!}, \quad A \subseteq \N\]
- Показати, що це дійсно визначає розподіл ймовірностей.
- Знайти\(\P(N \ge 3)\).
- Знайти\(\P(2 \le N \le 4)\).
Відповідь
- Зверніть увагу, що\( \sum_{n=0}^\infty \frac{e^{-1}}{n!} = 1 \)
- \(1 - \frac{5}{2} e^{-1}\)
- \(\frac{17}{24} e^{-1}\)
Розподіл ймовірностей, який регулює час між викидами, є окремим випадком експоненціального розподілу, тоді як розподіл ймовірностей, який регулює кількість викидів, є окремим випадком розподілу Пуассона, названого на честь Симеона Пуассон. Експоненціальний розподіл і розподіл Пуассона більш детально вивчені в розділі про процес Пуассона.
Відповідність
Припустимо, що у розсіяного секретаря готує 4 листи і відповідні конверти для відправки 4 різним особам, але потім записує листи в конверти випадковим чином. Знайдіть ймовірність події\(A\), що хоча б одна буква знаходиться в належному конверті.
Рішення
Зауважте спочатку, що набір результатів\( S \) може бути прийнятий як набір перестановок\(\{1, 2, 3, 4\}\). For\(\bs{x} \in S\),\(x_i\) - це номер конверта, що містить\(i\) й букву. Чітко\(S\) слід дати рівномірний розподіл ймовірностей. Далі зверніть увагу на те,\(A = A_1 \cup A_2 \cup A_3 \cup A_4\) де\(A_i\) знаходиться подія, що лист вставляється в\(i\) конверт.\(i\) Використання правила включення-виключення дає\(\P(A) = \frac{5}{8}\).
Ця вправа є прикладом задачі відповідності, спочатку сформульованої і вивченої П'єром Ремоном Монмортом. Повний аналіз задачі відповідності наведено в розділі про моделі скінченної вибірки.
У моделюванні узгодження експерименту вибираємо\(n = 4\). Виконати експеримент 1000 разів і обчислити відносну частоту події, що відбувається хоча б один збіг.
Вправи з аналізу даних
Для набору даних M&M давайте\(R\) позначимо подію, що мішок має щонайменше 10 червоних цукерок,\(T\) випадок, коли мішок має принаймні 57 цукерок загалом, і\(W\) випадок, коли мішок важить не менше 50 грам. Знайдіть емпіричну ймовірність наступних подій:
- \(R\)
- \(T\)
- \(W\)
- \(R \cap T\)
- \(T \setminus W\)
Відповідь
- \(\frac{13}{30}\)
- \(\frac{19}{30}\)
- \(\frac{9}{30}\)
- \(\frac{9}{30}\)
- \(\frac{11}{30}\)
Для даних цикади давайте\(W\) позначимо подію, що цикада важить не менше 0,20 грам,\(F\) подія, що цикада - самка, і\(T\) подія, що цикада - це тип тредекули. Знайдіть емпіричну ймовірність кожного з наступного:
- \(W\)
- \(F\)
- \(T\)
- \(W \cap F\)
- \(F \cup T \cup W\)
Відповідь
- \(\frac{37}{104}\)
- \(\frac{59}{104}\)
- \(\frac{44}{104}\)
- \(\frac{34}{104}\)
- \(\frac{85}{104}\)