
13,4: Відповідний детектор фільтра
- Page ID
- 34011
Вступ
Дуже багато застосувань в обробці сигналів, обробці зображень і за її межами передбачають визначення наявності та розташування цільового сигналу в межах якогось іншого сигналу. Наприклад, радіолокаційна система шукає копії переданого радіолокаційного імпульсу, щоб визначити наявність та відстань до світловідбиваючих об'єктів, таких як будівлі або літальні апарати. Система зв'язку шукає копії сигналів, що представляють цифрові 0 і 1s, щоб отримати повідомлення.
Двома ключовими математичними інструментами, які сприяють цим додаткам, є внутрішні продукти та нерівність Коші-Шварца. Як показано в модулі про нерівність Коші-Шварца, вираз\(\left|\left\langle\frac{x}{|| x||}, \frac{y}{\|y\|}\right\rangle\right|\) досягає своєї верхньої межі, яка дорівнює 1, коли\(y=ax\) для деякого скаляра\(a\) в дійсному або комплексному полі. Нижня межа, яка дорівнює 0, досягається, коли\(x\) і\(y\) є ортогональними. У неформальній інтуїції це означає, що вираз максимізується, коли вектори\(x\) і\(y\) мають однакову форму або візерунок і мінімізується, коли\(x\) і дуже\(y\) різні. Пара векторів з подібними, але неоднаковими формами або візерунками дасть відносно велике значення виразу менше 1, а пара векторів з дуже різними, але не ортогональними формами або візерунками дасть відносно невеликі значення виразу більше 0. Таким чином, вищевказане вираз несе в собі поняття про ступінь, до якої два сигнали «схожі», величину нормованої кореляції між сигналами у випадку стандартних внутрішніх продуктів.
Це поняття може бути надзвичайно корисним. Наприклад, розглянемо ситуацію, в якій ми хочемо визначити, який сигнал, якщо такий є, з набору\(X\) сигналів найбільше нагадує певний сигнал\(y\). Для цього ми могли б оцінити вищевказаний вираз для кожного сигналу\(x \in X\), вибравши той, який призводить до максимумів за умови, що ці максимуми перевищують певний поріг «подоби». Це ідея узгодженого детектора фільтра, який порівнює набір сигналів із цільовим сигналом, використовуючи вищевказаний вираз, щоб визначити, який найбільше схожий на цільовий сигнал.
Теорія детектора фільтрів
Порівняння сигналів
Найпростішим варіантом відповідної схеми детектора фільтра було б знайти сигнал члена в наборі\(X\) сигналів, які найбільш точно відповідають цільовому сигналу\(y\). Таким чином, для кожного\(x \in X\) бажаємо оцінити
\[m(x, y)=\left|\left\langle\frac{x}{|| x||}, \frac{y}{\|y\|}\right\rangle\right| \nonumber \]
для того, щоб порівняти кожного члена\(X\) з цільовим сигналом\(y\). Оскільки член,\(X\) який найбільш точно відповідає цільовому сигналу,\(y\) бажаний, в кінцевому підсумку ми хочемо оцінити
\[x_{m}=\operatorname{argmax} _{x \in X}\left|\left\langle\frac{x}{\|x\|}, \frac{y}{\|y\|}\right\rangle\right| \nonumber \]
Зверніть увагу, що цільовий сигнал технічно не потребує нормалізації для отримання максимуму, але дає бажану властивість, яка\(m(x,y)\) обмежена\([0,1]\).
Елемент\(x_{m} \in X\), який виробляє максимальне значення, не обов'язково\(m(x,y)\) є унікальним, тому може бути більше одного відповідного сигналу в\(X\). Крім того, сигнал,\(x_m \in X\) що виробляє максимальне значення,\(m(x,y)\) може не виробляти дуже велике значення\(m(x,y)\) і, таким чином, не дуже схожий на цільовий сигнал\(y\). Отже, інша відповідна схема фільтра може ідентифікувати аргумент, який створює максимум, але лише вище певного порогу, повертаючи не відповідні сигнали,\(X\) якщо максимум нижче порогового значення. Також може бути сигнал\(x \in X\), який виробляє велике значення\(m(x,y)\) і, таким чином, має високий ступінь «подоби»,\(y\) але не виробляє максимальне значення\(m(x,y)\). Таким чином, ще одна відповідна схема фільтра може ідентифікувати всі сигнали при\(X\) створенні локальних максимумів, які перевищують певний поріг.
Приклад\(\PageIndex{1}\)
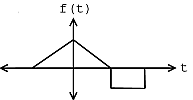
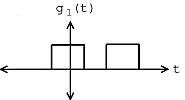
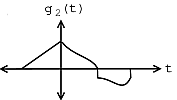
Наприклад, розглянемо цільовий сигнал, наведений на малюнку,\(\PageIndex{1}\) і набір двох сигналів, наведених на малюнку\(\PageIndex{2}\). За допомогою огляду видно, що сигнал\(g_2\) найбільше схожий на цільовий сигнал\(f\). Однак, щоб зробити цей висновок математично, ми використовуємо відповідний детектор фільтра з\(L_2\) внутрішнім продуктом. Якби ми насправді зробили необхідні обчислення, ми б спочатку нормалізували кожен сигнал, а потім обчислили необхідні внутрішні продукти, щоб порівняти сигнали\(X\) з цільовим сигналом\(f\). Ми б помітили, що абсолютне значення внутрішнього продукту для\(g_2\) з\(f\) при нормалізації більше абсолютного значення внутрішнього добутку\(g_1\) з\(f\) при нормалізації, математично заявлене як
\[g_{2}=\operatorname{arg max}_{x \in\left\{g_{1}, g_{2}\right\}}\left|\left\langle\frac{x}{\| x||}, \frac{f}{\|f\|}\right\rangle\right| \nonumber \]
Сигнали кандидатів
 (а)
 (б)
Виявлення шаблону
Дещо більш залучена схема детектора фільтра буде включати спробу зіставити сигнал, обмежений за цільовим часом,\(y=f\) до набору зрушених у часі і віконних версій одного сигналу,\(X=\left\{w S_{t} g \mid t \in \mathbb{R}\right\}\) індексованого\(\mathbb{R}\). Функція вікна\(\left[t_{1}, t_{2}\right]\) задається\(w(t)=u\left(t-t_{1}\right)-u\left(t-t_{2}\right)\) де інтервал, до якого\(f\) обмежений час. Ця схема може бути використана для пошуку частин\(g\), які мають ту ж форму, що і\(f\). Якщо абсолютне значення внутрішнього добутку нормованих версій\(f\) і\(w S_{t} g\) велике, що є абсолютним значенням нормованої кореляції для стандартних внутрішніх продуктів, то\(g\) має високий ступінь «подоби» до\(f\) на інтервалі, до якого\(f\) знаходиться час обмежений, але ліворуч зміщений\(t\). Звичайно, якщо\(f\) не обмежений часом, це означає, що весь сигнал має високий ступінь «подоби»\(f\) лівого зміщеного на\(t\).
Таким чином, для того, щоб визначити найбільш ймовірні місця розташування сигналу з тією ж формою, що і цільовий сигнал\(f\) у сигналі,\(g\) ми хочемо обчислити
\[t_{m}=\operatorname{argmax}_{t \in \mathbb{R}} \mid\left\langle\frac{f}{\|f\|}, \frac{w S_{t} g}{\left\|w S_{t} g\right\|}\right\rangle \nonumber \]
забезпечити бажану зміну. Припускаючи, що досліджуваний внутрішній простір продукту є\(L_2\)\(\mathbb{R}\) (аналогічні результати тримають\(L_{2}(\mathbb{R}[a, b))\)\(l_2(\mathbb{Z})\), і\(l_{2}(\mathbb{Z}[a, b))\)), це виробляє
\[t_{m}=\operatorname{argmax}_{t \in \mathbb{R}}\left|\frac{1}{\|f\|\left\|w S_{t} g\right\|} \int_{-\infty}^{\infty} f(\tau) w(\tau) \overline{g(\tau-t)} d \tau\right| \nonumber \]
Так як\(f\) і\(w\) час обмежується одним і тим же інтервалом
\[t_{m}=\operatorname{argmax}_{t \in \mathbb{R}}\left|\frac{1}{\|f\|\left\|w S_{t} g\right\|} \int_{t_{1}}^{t_{2}} f(\tau) \overline{g(\tau-t)} d \tau\right| \nonumber \]
Здійснюючи заміну\(h(t)=\overline{g(-t)}\),
\[t_{m}=\operatorname{argmax}_{t \in \mathbb{R}}\left|\frac{1}{\|f\|\left\|w S_{t} g\right\|} \int_{t_{1}}^{t_{2}} f(\tau) h(t-\tau) d \tau\right|. \nonumber \]
Відзначаючи, що цей вираз містить операцію згортки
\[t_{m}=\operatorname{argmax}_{t \in \mathbb{R}}\left|\frac{(f * h)(t)}{\|f\|\left\|w S_{t} g\right\|}\right| \nonumber \]
де\(h\) - сполучений час зворотної версії,\(g\) визначеної\(h(t)=\overline{g(-t)}\).
В особливому випадку, коли цільовий сигнал\(f\) не обмежений часом,\(w\) має одиничне значення на всій реальній лінії. Таким чином, норма може бути оцінена як\(\left\|w S_{t} g\right\|=\left\|S_{t} g\right\|=\|g\|=\|h\|\). Тому функція зводиться\(t_{m}=\operatorname{argmax}_{t \in \mathbb{R}} \frac{\left(f * h\right)(t)}{\|f\|\left\|h\right\|}\) куди\(h(t)=\overline{g(-t)}\). Функція\(f * g=\frac{\left(f * h\right)(t)}{\|f\|\left\| h\right\|}\) відома як нормована перехресна кореляція\(f\) і\(g\).
Отже, ця відповідна схема фільтра може бути реалізована як згортка. Тому може бути доцільним реалізувати його в частотній області. Подібні результати тримають для\(L_{2}(\mathbb{R}[a, b))\)\(l_{2}(\mathbb{Z})\), і\(l_{2}(\mathbb{Z}[a, b])\) пробілів. Особливо корисно реалізувати\(l_{2}(\mathbb{Z}[a, b])\) випадки в частотній області, оскільки потужність алгоритму швидкого перетворення Фур'є може бути використана для швидкого виконання обчислень в комп'ютерній програмі. У\(l_{2}(\mathbb{Z}[a, b])\) випадках\(L_{2}(\mathbb{R}[a, b))\) та випадках слід подбати про нульовий сигнал, якщо ефекти обгортання не бажані. Подібні результати також мають місце для просторів на більш високих розмірних інтервалах з однаковими внутрішніми виробами.
Звичайно, не обов'язково точно один екземпляр цільового сигналу в даному сигналі. Там може бути один екземпляр, більше одного екземпляра, або жоден екземпляр цільового сигналу. Тому часто практичніше виявляти всі зрушення, відповідні локальним максимумам, які знаходяться вище певного порогу.
Приклад\(\PageIndex{2}\)
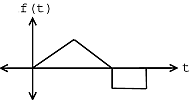
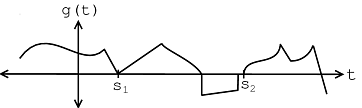
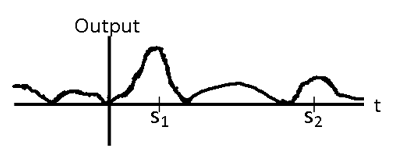
Сигнал на малюнку\(\PageIndex{4}\) містить екземпляр шаблонного сигналу, який видно на малюнку, що\(\PageIndex{3}\) починається в той час\(t=s_1\), як показано на графіку на малюнку\(\PageIndex{5}\). Тому
\[s_{1}=\operatorname{argmax}_{t \in \mathbb{R}}\left|\left\langle\frac{f}{\|f\|}, \frac{w S_{t} g}{\left\|w S_{t} g\right\|}\right\rangle\right|. \nonumber \]
практичне застосування
Виявлення зображень
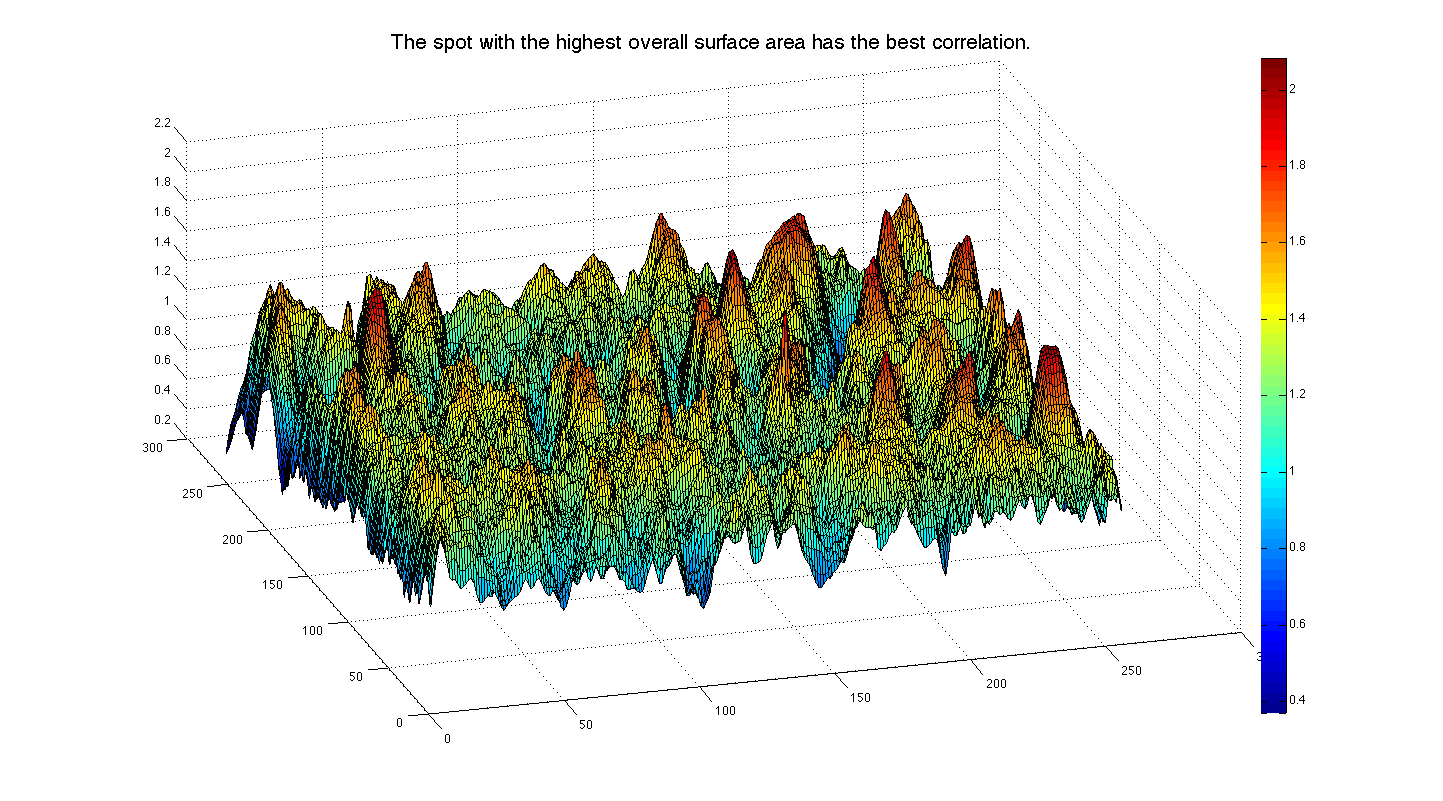
Відповідна фільтрація використовується в обробці зображень для виявлення шаблонного зображення в еталонному зображенні. Це має реальні програми для перевірки відбитків пальців для безпеки або перевірки чиєїсь фотографії. Як простий приклад можна звернутися до постійно популярного «Де Вальдо?» книги (відомий як Уоллі у Великобританії!) , де читачеві покладено завдання знайти конкретне обличчя Вальдо/Уоллі в заплутаній фоні рясніє з look-alikes! Якщо нам задано головку шаблону і еталонне зображення, ми можемо виконати двовимірну згортку шаблонного зображення по еталонному зображенню, щоб отримати тривимірну карту згортки\(\PageIndex{6(a)}\), Рисунок, де висота карти згортки визначається ступенем кореляції, вище буття більш корельованих. Тоді пошук нашої мети стає питанням визначення місця, де місцева площа поверхні є найвищою. Процес продемонстрований на рис\(\PageIndex{6(b)}\). У галузі обробки зображень цей відповідний процес на основі фільтра відомий як відповідність шаблону.
 (а)
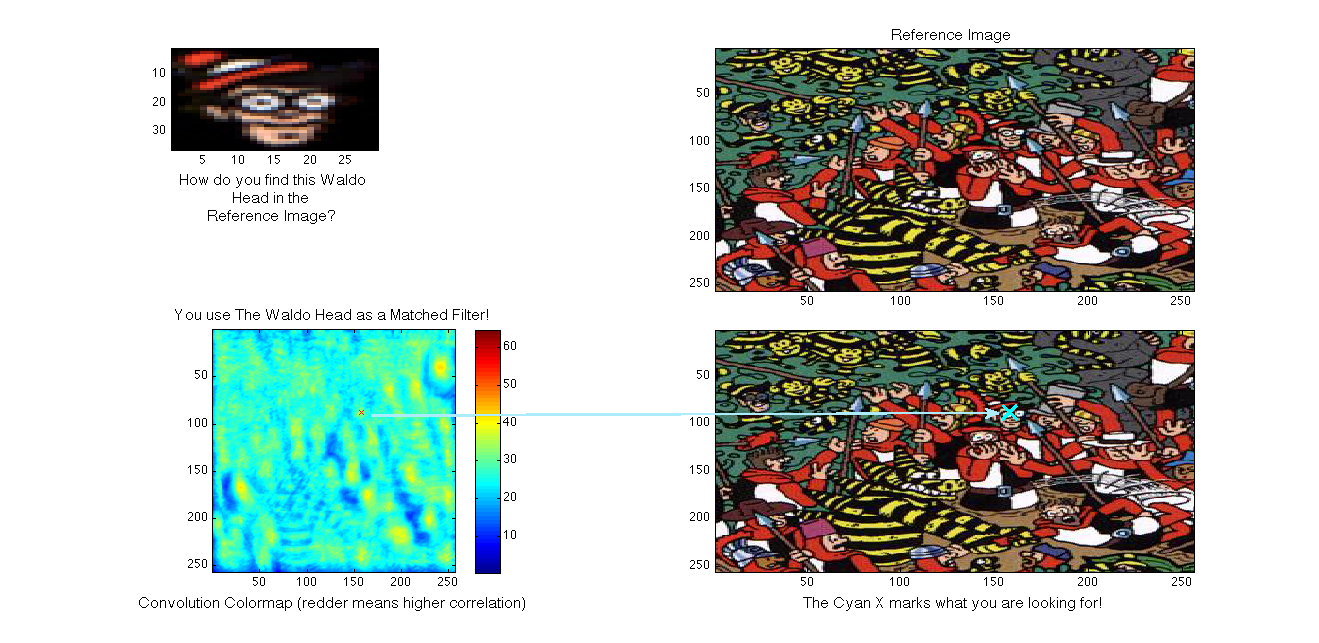 (б)
тоді ми могли б легко розробити програму, щоб знайти найближчу схожість із зображенням голови Уолдо на більшій картині. Ми просто реалізуємо наш той самий алгоритм фільтра матчу: візьміть внутрішні продукти на кожній зміні і дивіться, наскільки великі наші отримані відповіді. Ця ідея була реалізована на цій самій картині для проекту сигналів і систем в Університеті Райса (натисніть на посилання, щоб дізнатися більше).
Вправа\(\PageIndex{1}\): Pros and Cons
Які переваги алгоритму узгодженого фільтра для виявлення зображень? Які недоліки у цього методу?
- Відповідь
-
Цей алгоритм дуже простий і, таким чином, легко кодувати. Однак він сприйнятливий до певних типів шуму - наприклад, було б важко знайти Вальдо, якби його обличчя було повернуто, перевернуто, більше або менше, ніж очікувалося, або спотворено якимось іншим способом.
Системи зв'язку
Відповідні детектори фільтрів також зазвичай використовуються в системах зв'язку. Насправді вони є оптимальними детекторами гаусового шуму. Сигнали в реальному світі часто спотворюються навколишнім середовищем, тому існує постійна боротьба за розробку способів отримати спотворений сигнал, а потім мати можливість фільтрувати його якимось чином, щоб визначити, яким був вихідний сигнал. Відповідні фільтри забезпечують один спосіб порівняти прийнятий сигнал з двома можливими оригінальними («шаблонними») сигналами та визначити, який з них є найближчим відповідністю прийнятому сигналу.
Наприклад, нижче ми маємо спрощений приклад частотного зсуву клавіш (FSK), де ми маємо наступне кодування для «1» та «0»:
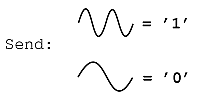
Виходячи з вищезазначеного кодування, ми можемо створювати цифрові сигнали на основі 0 та 1, складаючи два вищевказані «коди» нескінченною кількістю способів. Для цього прикладу ми передамо базове 3-бітове число, 101, яке відображається на малюнку\(\PageIndex{8}\):
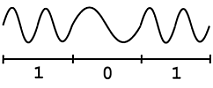
Тепер, зображення сигналу вище являє собою наш оригінальний сигнал, який буде передаватися через якусь систему зв'язку, яка неминуче пройде через «канал зв'язку», частина системи, яка буде спотворювати і змінювати наш сигнал. Поки шум не надто великий, наш відповідний фільтр повинен утримати нас від необхідності турбуватися про ці зміни нашого переданого сигналу. Після того, як цей сигнал буде отриманий, ми передамо галасливий сигнал через просту систему, подібну до спрощеної версії, показаної на малюнку\(\PageIndex{9}\):
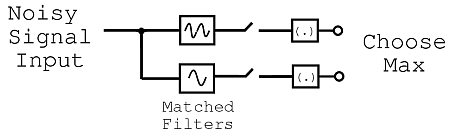
Малюнок в\(\PageIndex{9}\) основному показує, що наш галасливий сигнал буде передаватися (ми будемо вважати, що він проходить по одному «біту» за раз), і цей сигнал буде розділений і переданий двом різним відповідним детекторам фільтра. Кожен з них буде порівнювати галасливий, прийнятий сигнал з одним із двох кодів, які ми визначили для «1» та «0». Тоді це значення буде передано, і залежно від того, яке значення вище (тобто незалежно від сигналу FSK коду, який найбільше нагадує галасливий сигнал) буде значенням, яке приймає приймач. Наприклад, перший біт, який буде надіслано, буде «1», тому верхній рівень блок-схеми матиме більш високе значення, що означає, що сигнал «1» був надісланий, навіть якщо сигнал може здатися дуже шумним і спотвореним.
Інтерактивний приклад нижче передбачає, що наш передавач надсилає 1000 біт, будуючи, скільки з цих бітів приймаються та інтерпретуються правильно як 1s та 0s, а також зберігає підрахунок того, скільки випадково неправильно інтерпретуються. Ви можете пограти з відстанню між енергією «1» і «0» (розбірливість), ступенем шуму, присутнього в каналі, і розташуванням критерію (порога), щоб відчути основи теорії виявлення сигналів.
Приклад\(\PageIndex{3}\)
Давайте скористаємося відповідним фільтром, щоб знайти біти «0» у простому сигналі.
Давайте використаємо сигнал\(s_1(t)\) від Example\(\PageIndex{1}\) для представлення бітів. \(s_1(t)\)представляє 0, а\(-s_1(t)\) представляє 1.
\(0 \Rightarrow(b=1) \Rightarrow\left(s_{1}(t)=s(t)\right)\)для\(0≤t≤T\)
\(1 \Rightarrow(b=-1) \Rightarrow\left(s_{2}(t)=-s(t)\right)\)для\(0≤t≤T\)
\[X_{t}=\sum_{i=-P}^{P} b_{i} s(t-i T) \nonumber \]
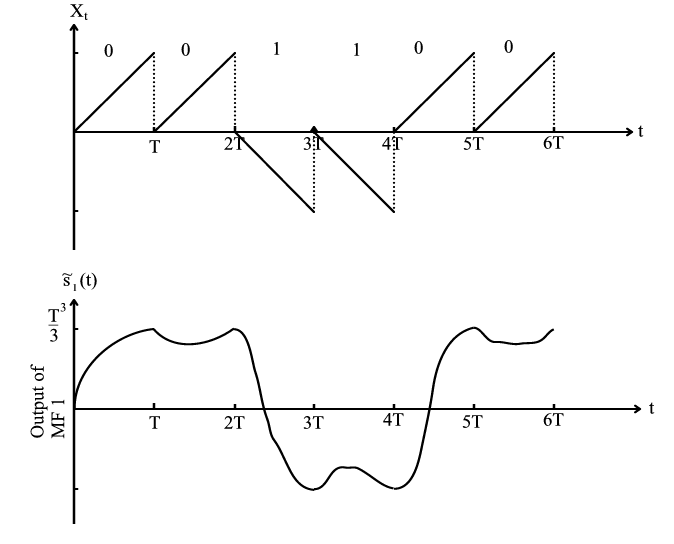
Малюнок\(\PageIndex{10}\)
Відповідний вихід фільтра чітко показує розташування бітів «0».
Радар
Однією з перших і більш інтригуючих форм зв'язку, яка використовувала концепцію узгодженого фільтра, був радар. Відомий електромагнітний сигнал надсилається передавачем на ціль і відбивається від цілі назад відправнику з тимчасовою затримкою, пропорційною відстані між ціллю та відправником. Цей масштабований, зсунутий у часі сигнал потім згортається з вихідним шаблонним сигналом, і відзначається час, коли вихід цієї згортки є найвищим.
Ця технологія виявилася життєво важливою в 1940-х роках для держав, які нею володіли. Короткий набір відео нижче показує основи роботи технології, її застосування та її вплив у Другій світовій війні.
Малюнок\(\PageIndex{11}\)
Дивіться відео на малюнку\(\PageIndex{12}\) для аналізу того ж основного принципу, що застосовується до адаптивних систем круїз-контролю для сучасного автомобіля.
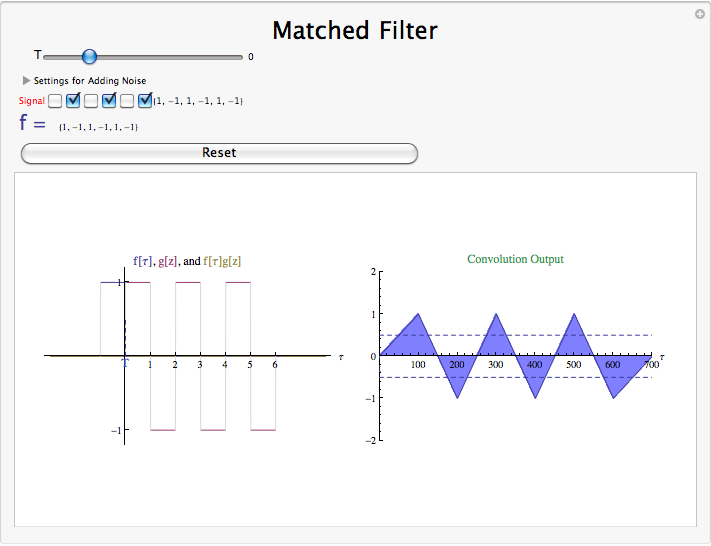
Демонстрація відповідного фільтра
Підсумок відповідного фільтра
Як видно, узгоджений детектор фільтра є важливим додатком для обробки сигналів, багатим як теоретичними концепціями, так і на практичне застосування. Відповідний фільтр підтримує широкий спектр застосувань, пов'язаних з розпізнаванням образів, включаючи виявлення зображення, демодуляцію клавіатури зі зміщенням частоти та інтерпретацію радіолокаційного сигналу. Незважаючи на таку різноманітність цілей, всі відповідні програми фільтрів працюють по суті однаково. Кожен член деякого набору сигналів порівнюється з цільовим сигналом шляхом оцінки абсолютного значення внутрішнього добутку двох сигналів після нормалізації. Однак набори сигналів та інтерпретації результатів є специфічними для застосування.